Свежие статьи

Рубрики

Рубрика: Личный опыт и Путь в IT

Как я учился программировать с нуля: личный опыт, ошибки, полезные ресурсы и мотивация. Для тех, кто хочет войти в IT, но не знает, с чего начать.

  • Почему я взял паузу в разработке и начал писать статьи: что изменилось в моём подходе

    Почему я взял паузу в разработке и начал писать статьи: что изменилось в моём подходе

    Меня зовут Константин Милютин. Это мой дневник — место, где я фиксирую свой путь в IT с помощью ИИ, свои ошибки и выводы. Это блог не для развлекательного контента. Этот блог мой отчёт о проделанной работе и об опыте, который я приобретаю каждый день. Цель блога — помочь Вам не совершать мои ошибки и быстрее прийти к результату.

    Если ты читал мои предыдущие записи, ты знаешь: я прошёл длинный путь. Начинал с PHP-плагина, перешёл на Python, написал с помощью ИИ плагин для автопостинга в ВК, выложил его в официальный репозиторий WordPress.org, а потом отказался его продавать. Я исправил больше 30 ошибок, прошёл четыре раунда ревью, настроил SEO вручную без плагинов. Для  SEO правил код и создал дочернюю тему с помощью deepseek. 

    И вот теперь я беру паузу. Не потому, что устал. И не потому, что всё сломалось. А потому, что понял одну важную вещь: я слишком долго воевал с платформами и забыл, зачем всё это делаю.

    Сегодня я хочу разобраться в этом. Зафиксировать. Понять, почему пауза в разработке — это не отказ от мечты, а осознанная стратегия. И почему я решил сфокусироваться на контенте, а не на коде.

    Как я понял, что пора остановиться

    Всё началось с VK API. Мой плагин для автопостинга в ВК работал стабильно, но потом ВК ввёл новые ограничения. Из-за этого сервис, через который плагин получал доступ к API, перестал работать. И как следствие — мой плагин перестал публиковать картинки. Текст и ссылка на статью публикует, а изображения — нет.

    Я не переписывал код. Я не искал обходные пути. Потому что проблема была не в моём коде. Проблема была в том, что ВК изменил правила. И никакие мои усилия не могли это исправить.

    Потом WordPress.org заблокировал доступ к странице моего плагина. Просто так, без объяснений. Через несколько дней доступ вернули, но осадок остался. Я понял, что я не контролирую свою же работу. Я завишу от чужих решений.

    И тогда я задал себе вопрос: «А зачем мне это?»

    Я вспомнил, зачем я вообще начал программировать. Я хотел создавать полезные инструменты. Я хотел делиться опытом. Я хотел учиться и расти. Но вместо этого я тратил всё время на борьбу с платформами, которые меняют правила без предупреждения.

    Это выматывает. Это приносит временный результат. И это не то, чем я хочу заниматься.

    Что сломалось и чему это меня научило

    Я не буду делать вид, что всё было гладко. Было несколько моментов, которые меня действительно выбили из колеи.
    Что сломалось и чему это меня научило

    Первое — VK API. Когда ВКонтакте ввёл ограничения, сервис, через который мой плагин получал доступ к API, перестал работать. Картинки перестали публиковаться. Текст и ссылка на статью уходят, а изображения — нет. Я начал искать в чем проблема, чтобы понять, что происходит. Как оказалось проблема была не в моём коде. Проблема была в том, что ВК решил ограничить доступ. И это не в моих силах.

    Второе — WordPress.org. Когда доступ к странице плагина заблокировали, я сначала подумал, что это ошибка. Потом — что это связано с обновлением. Но потом понял: это просто очередное событие с которым я ничего не мог сделать.

    И тогда я понял: я завишу от платформ. Я не контролирую свою работу. Я не могу гарантировать, что завтра всё будет работать так же, как сегодня.

    Это не то, что я хочу. Это не то, ради чего я начал этот путь.

    Почему пауза — это не отказ, а стратегия

    Я хочу зафиксировать одну вещь: я не бросаю программирование. Я не отказываюсь от своих проектов. Я просто меняю приоритеты.

    Пауза в разработке — это не слабость. Это осознанное решение. Я понял, что тратить всё время на борьбу с платформами — это путь в никуда. Я не могу построить что-то стабильное, если я завишу от чужих API и чужих правил.

    Но что я могу построить? Что не зависит от платформ? Что работает годами и не ломается при обновлении?

    Ответ прост: контент.

    Контент — это единственный актив, который работает годами. Он не зависит от API. Он не ломается при обновлении платформ. Он не блокируется без предупреждения. Он живёт своей жизнью и приносит пользу людям.

    Именно поэтому я решил сфокусироваться на контенте. Я буду писать статьи. Я буду делиться опытом. Я буду строить блог, который не зависит от капризов платформ.

    Разработка никуда не уходит, так как мне нужен опыт. Я просто пока что не буду делиться тем, над чем работаю. Когда я буду точно знать, что нужно моим читателям. Когда я буду уверен, что мой код не сломается через месяц. Я начну об этом рассказывать.

    А пока — контент. Полезные статьи. Живые истории. Честные выводы.

    Что я делаю, пока не пишу код и что изменилось в моём подходе

    Что я делаю, пока не пишу код

    Моя пауза в разработке — это не безделье. Я не сижу и не жду, когда что-то изменится. Я работаю. Просто иначе.

    Первое — я пишу статьи. Каждую неделю я публикую новый материал. Это может быть история о моём опыте, разбор ошибок, практический совет или просто размышление. Главное — чтобы это было полезно.

    Второе — я строю план контента. Я не пишу хаотично. У меня есть план на несколько месяцев вперёд. Я знаю, какие темы буду раскрывать, какие истории рассказывать, какие выводы делать. Но они могут меняться исходя из моего опыта.

    Третье — я учусь писать лучше. Я работаю с ИИ, но не позволяю ему писать за меня. Я использую его как помощника: для структуры, для идей, для проверки. Но голос остаётся моим.

    Четвёртое — я строю сообщество единомышленников. Я не жду, что люди придут сами. Я делюсь статьями в группе ВК, отвечаю на вопросы, общаюсь с читателями. Я строю сообщество единомышленников.

    Пятое — я не забываю про разработку. Я не забрасываю код. Я просто не гонюсь за моментным результатом. Сейчас есть действительно важные для меня идеи, как найду способ сделать их стабильными и независимыми, я вернусь к полной их разработке. Но сейчас мой приоритет — контент.

    Это не значит, что я перестал быть разработчиком. Это значит, что я стал ещё и автором. И это только улучшило моё понимание того, что я делаю.

    Что дальше?

    Я не знаю, когда вернусь к разработке. Может быть, через месяц. Может быть, через год. Но я знаю точно: я не брошу программирование. Я просто меняю приоритеты.

    Сейчас мой фокус — контент. Я буду писать статьи. Я буду делиться опытом. Я буду строить блог, который помогает людям.

    А когда придёт время — я покажу Вам код. Но это будет уже другой код. Это будет код, который я напишу с ясным пониманием того, что нужно моим читателям и мне. Это будет код, который я напишу с уверенностью, а не бояться, что он перестанет работать из-за правил платформ.

    Потому что я понял главное: я не бросаю программирование. Я меняю свои приоритеты.

    И это — правильное решение.

    Если ты тоже чувствуешь и понимаешь, что застрял в борьбе с правилами платформ, если ты устал от того, что твои проекты ломаются из-за чужих решений — остановись. Подумай. Может быть, тебе тоже стоит взять паузу. Сфокусироваться на контенте. Сделать проект, который не зависит от капризов платформ.

    Это не слабость. Это стратегия. И это работает.

    Читай мой дневник, подписывайся на обновления, делись своим опытом. Вместе мы строим то, что останется.

    Группа ВК: vk.com/milyutin_codes
    Email: milyutinkv@gmail.com

  • Как я увлёкся программированием и забыл о SEO: история ручной настройки сайта без плагинов

    Как я увлёкся программированием и забыл о SEO: история ручной настройки сайта без плагинов

    Последние месяцы я жил в режиме непрерывного кодинга. Плагин для ВК, Python-скрипты, ревью в WordPress.org — и вот однажды я заглянул в Яндекс. Вебмастер и понял, что моего сайта там нет. Совсем.

    milyutin-codes.ru не индексировался. Ни одной страницы в поиске. Блог, в который я вложил месяцы работы, был невидим.

    И это стало отправной точкой для новой эпопеи. Я решил отказаться от SEO-плагинов и написать всё вручную. Если уж я пишу код, то пусть он будет полностью моим.

    Как я увлёкся и что упустил

    Всё началось с того, что я погрузился в разработку. Каждый день я что-то писал: то плагин для ВК, то Python-скрипт для автопостинга, то пытался починить очередной баг. Мне нравилось создавать. Мне нравилось решать задачи. Мне нравилось чувствовать себя разработчиком.

    Но в этой гонке я перестал думать о том, для чего всё это делается. Я создавал статьи, публиковал их, но не задумывался: а увидят ли их люди? Найдут ли их поисковые системы? Будут ли они приносить трафик?

    Ответ был неутешительным. Нет. Не найдут. Не будут.

    Я запустил поиск по своему сайту в Яндексе и Google. Ноль результатов. Сайт не индексировался. Мой блог, в который я вложил столько сил, был невидим для поисковиков.

    Забыл о SEO: ручная настройка WordPress без плагинов
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Это был удар. Я осознал, что всё это время строил дом без фундамента. Красивый, с хорошей отделкой, но без фундамента.

    Решение: отказаться от SEO-плагинов

    SEO-плагин
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Когда я понял масштаб проблемы, первая мысль была: «Поставлю Yoast SEO или Rank Math, и всё наладится». Это логично. Тысячи сайтов используют эти плагины. Они генерируют sitemap, настраивают мета-теги, добавляют Schema.org, управляют robots.txt.

    Но я остановился. Потому что вспомнил, зачем я вообще начал этот путь.

    Я начал его, чтобы учиться. Чтобы понимать, как всё работает изнутри. Чтобы не зависеть от готовых решений, которые я не контролирую.

    И я принял решение: никаких SEO-плагинов. Всё вручную.

    Это было сложнее. Это заняло больше времени. Но это дало мне полный контроль. И, что важнее, понимание.

    Борьба с кодом: как я настраивал SEO вручную

    Борьба с кодом
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я начал с создания дочерней темы для Twenty Twenty-Five. Это базовый шаг, который позволяет вносить изменения, не трогая родительскую тему. Я создал папку `twentytwentyfive-child`, файлы `style.css` и `functions.php`.

    Дальше началась настоящая работа.

    **Мета-теги и заголовки**

    Я добавил в `functions.php` код, который:
    — Позволяет задавать SEO-заголовок и SEO-описание для каждого поста через мета-боксы.
    — Автоматически формирует заголовок страницы через фильтр `pre_get_document_title`.
    — Выводит мета-тег description в `<head>`.

    Это было непросто. Пришлось разбираться с nonce, санитизацией и экранированием. Но я справился.

    Robots.txt

    Я создал файл `robots.txt` в корне сайта. Он закрывает служебные разделы (`/wp-admin/`, `/wp-includes/`), но открывает рубрики (`/category/`) для индексации.

    Это был важный шаг. Раньше я закрывал всё подряд, не понимая, что лишаю свой сайт трафика.

    **Управление индексацией архивов**

    Я добавил мета-тег `noindex, follow` для всех архивных страниц: рубрик, меток, дат, авторов. Это позволяет не плодить дубли и сконцентрировать вес на постах.

    Open Graph и Twitter Cards

    Я добавил код, который автоматически генерирует теги Open Graph и Twitter Cards для каждой страницы. Теперь, когда кто-то делится ссылкой на мою статью в Telegram или ВКонтакте, там отображается красивое превью с заголовком, описанием и картинкой.

    Schema.org

    Я добавил JSON-LD разметку для статей (тип BlogPosting) и для страницы блога (тип Blog). Это помогает поисковикам лучше понимать, что на странице — статья или архив.

    Sitemap

    Я создал XML-карту сайта. Правда, с ней были проблемы: сначала она была недоступна, потом все даты `lastmod` были одинаковыми. Но я исправил это.

    Многократные итерации: как я проверял и перепроверял

    Многократные итерации
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я не могу сказать, что всё получилось с первого раза. Это было далеко не так.

    Я обращался к DeepSeek за помощью. Мы вместе анализировали код, искали ошибки, проверяли результаты. И каждый раз DeepSeek находил что-то новое.

    Сначала он сказал, что sitemap недоступен. Я исправил.

    Потом — что Open Graph на странице блога дублирует главную. Я исправил.

    Потом — что Schema.org на странице блога описывает конкретную статью, а не архив. Я исправил.

    Потом — что на странице блога нет статических ссылок на статьи. И вот тут мы застряли.

    Это была самая сложная проблема. Страница `/blog/` загружала список статей через JavaScript. В HTML-коде не было ни одной ссылки на статьи. Для поискового робота это выглядело так, будто на странице нет контента.

    DeepSeek предложил решение: вывести список статей через `WP_Query` или `get_posts()` прямо в шаблоне. Я попробовал. И это сработало.

    Что в итоге получилось

    Что в итоге получилось
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Сегодня мой сайт — это полноценная SEO-система, написанная вручную, без единого плагина.

    Что работает:
    — ✅ Мета-теги, Open Graph, Twitter Cards — уникальны для каждой страницы.
    — ✅ Schema.org разметка — для статей и архивов.
    — ✅ Robots.txt — открывает рубрики, закрывает служебные разделы.
    — ✅ Sitemap.xml — содержит список всех страниц с корректными датами.
    — ✅ Canonical — для каждой страницы.
    — ✅ Статические ссылки на статьи — в HTML-коде страницы блога.
    — ✅ Управление индексацией архивов — через мета-теги.

    Что ещё требует доработки:
    — ⚠️ Sitemap иногда недоступен из-за особенностей хостинга. Работаю над этим.
    — ⚠️ Индексация пока нулевая. Но это вопрос времени — сайт молодой, и поисковики не торопятся.
    — ⚠️ Некоторые теги закрыты от индексации. Но это осознанное решение.

    Что я понял за это время

    1. Увлечение — это хорошо, но нельзя забывать о фундаменте.

    Я так увлёкся программированием, что забыл: сайт — это не только код. Это ещё и контент, который должен быть найден. SEO — это фундамент, без которого всё остальное теряет смысл.

    2. Плагины — это не всегда решение.

    Я отказался от SEO-плагинов и не жалею. Да, было сложнее. Да, пришлось разбираться во многом. Но теперь я понимаю, как всё работает. И могу контролировать каждый аспект.

    3. DeepSeek — это не просто помощник.

    Он помог мне не только с кодом, но и с пониманием того, что я упустил. Иногда лучший совет — это не «как сделать», а «на что обратить внимание».

    4. Многократные итерации — это нормально.

    Я проверял сайт раз за разом. Каждый раз находились новые ошибки. Это не провал. Это процесс. Главное — не останавливаться.

    5. Индексация — это не мгновенный процесс.

    Мой сайт до сих пор не в индексе. Но это не значит, что я делаю что-то не так. Это значит, что поисковики ещё не обошли его. Я продолжаю работать, отправляю sitemap в Вебмастер и GSC, публикую контент. И верю, что результат придёт.

    Что дальше?

    Продолжение следует
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я продолжу улучшать SEO своего сайта. В планах:
    — Добиться стабильной доступности sitemap.
    — Настроить разные `lastmod` для каждой страницы.
    — Добавить внутреннюю перелинковку (блок «Читайте также»).
    — Улучшить скорость загрузки.

    А главное — продолжать публиковать контент. Потому что SEO = 20% техники + 80% контента. Техническая часть у меня почти идеальная. Теперь важно наполнять сайт полезными материалами.

    Если ты тоже увлёкся программированием и забыл о SEO — остановись на минуту. Проверь свой сайт. Посмотри, индексируется ли он. Есть ли у тебя sitemap. Правильно ли настроен robots.txt.

    Это не так сложно, как кажется. Да, придётся разобраться. Да, будет не с первого раза. Но это стоит того. Потому что сайт, который не находят люди, — это сайт, который не существует.

    Подписывайся на мой блог, чтобы следить за моим путём. Вместе мы строим полезные инструменты и учимся делать всё правильно.

    Контакты

    📧 Email: milyutinkv@gmail.com
    🌐 Сайт: milyutin-codes.ru
    💬 Группа ВК: vk.com/milyutin_codes

    Задавай вопросы, делись идеями, тестируй плагины. Вместе мы строим полезные инструменты!

    Продолжение следует. Сайт индексируется, плагины работают, SEO настроено вручную.

    Константин Милютин
    Автор блога «Милютин Код»

  • Почему я не стал продавать плагины и начал их отдавать бесплатно

    Почему я не стал продавать плагины и начал их отдавать бесплатно

    Я прошёл долгий путь от новичка в IT до автора плагина, который официально опубликован в репозитории WordPress.org. Это был тернистый путь. Я пробовал PHP, перешёл на Python, переделывал код с нуля несколько раз, проходил четыре раунда ревью в WordPress.org.

    И вот мой плагин «Milyutin Code Article Reposter for VK» доступен для скачивания. Казалось бы — можно вздохнуть с облегчением и начать зарабатывать.

    Но я принял другое решение. Я не буду продавать свои плагины. Совсем.

    Откуда ноги растут

    Создавать для души — это не про деньги, это про свободу
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Когда я только начинал, я думал как многие: «Сделаю крутой плагин, выложу его в репозиторий, а потом сделаю Pro-версию и буду продавать». Звучит логично, правда? Бесплатная версия привлекает пользователей, платная приносит доход. Freemium-модель работает у тысяч разработчиков.

    Но чем дальше я погружался в разработку, тем больше меня мучил один вопрос: «А хочу ли я этим заниматься?»

    У меня за плечами годы работы в продажах. Я знаю, как это работает изнутри. Ты продаёшь продукт, людям нравится — они молчат. Как только появляется ошибка, баг или что-то идёт не по их плану — на тебя выливают всё, что накопилось. И неважно, что ты делал это бесплатно или за копейки.

    «Когда хорошо — люди молчат, а как только ошибка — всё гавно выливают на тебя». Это не про клиентов. Это про реальность продаж, которую я знаю не понаслышке.

    Я представил, как буду тратить вечера на поддержку платной версии, отвечать на претензии, доказывать, что я не лох, а просто человек, который тоже может ошибаться. И понял: это не моё.

    Момент истины

    Момент истины
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Помню, когда я проходил ревью в WordPress.org, я исправлял одну ошибку за другой. Плагин переделывался с нуля несколько раз. Были моменты, когда я хотел всё бросить. Но я продолжал.

    И в какой-то момент я осознал: я делаю это не ради денег. Я делаю это потому, что мне нравится процесс. Мне нравится решать задачи, создавать что-то полезное, видеть, как мои инструменты помогают другим людям.

    Я вспомнил, зачем вообще начал этот блог. Я хотел делиться опытом, показывать свой код, учиться на ошибках и помогать другим не наступать на те же грабли. А не продавать плагины и беспокоиться о доходах.

    И тогда я принял решение: никаких платных версий. Никаких Pro. Только бесплатные плагины и открытый код.

    Почему бесплатные плагины — это круто

    Почему я не стал продавать плагины

    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я знаю, что многие разработчики скажут: «Но это же нереально. Ты потратил кучу времени, а ничего не заработаешь». Я понимаю этот аргумент. Но у меня другая логика.

    Бесплатные плагины — это моё портфолио.

    Каждый скачанный плагин, каждый отзыв, каждая звезда на WordPress.org — это доказательство того, что я могу делать качественные продукты. Это работает лучше любого резюме.

    Бесплатные плагины — это доверие.

    Когда ты даёшь людям что-то бесплатно и это работает, они начинают тебе доверять. Они подписываются на блог, заходят в группу ВК, следят за новыми проектами. А доверие — это самая ценная валюта в интернете.

    Бесплатные плагины — это обратная связь.

    Я получаю реальные отзывы от реальных пользователей. Они пишут о багах, предлагают улучшения, делятся идеями. Это делает мои плагины лучше. Если бы я продавал их, я бы получал в основном жалобы, а не конструктивную критику.

    Бесплатные плагины — это свобода.

    Я не привязан к доходам. Я могу экспериментировать, пробовать новые подходы, не боясь, что провал ударит по кошельку. Я могу отдать код в открытый доступ, зная, что кто-то может его улучшить.

    Что дальше?

    Почему я не стал продавать плагины
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Мой первый плагин уже доступен всем желающим. Сейчас я работаю над следующими инструментами. И все они тоже будут бесплатными.

    В планах:

    • Плагин для SEO-оптимизации WordPress без лишних надстроек.

    • Python-скрипты для автоматизации рутины.

    • Гайды по установке, настройке и использованию этих инструментов.

    Я продолжу писать в блог, делиться кодом и рассказывать о своих ошибках. Потому что это — моя настоящая ценность. Не плагины, а опыт, который я могу передать другим.

    Призыв к действию

    плагин
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Если ты тоже разработчик-самоучка и стоишь перед выбором: продавать или отдавать бесплатно — послушай себя. Что тебе действительно нравится? Создавать или продавать? Поддерживать пользователей или получать деньги?

    Я выбрал первое. И ни разу не пожалел.

    🔗 Скачай мой плагин бесплатно: wordpress.org/plugins/milyutin-code-article-reposter-for-vk/

    Подписывайся на блог и группу ВК, чтобы не пропустить новые инструменты.

    Контакты

    📧 Email: milyutinkv@gmail.com
    🌐 Сайт: milyutin-codes.ru
    💬 Группа ВК: vk.com/milyutin_codes

    Задавай вопросы, делись идеями, тестируй плагины. Вместе мы строим полезные инструменты!

    Почему я не стал продавать плагины
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Продолжение следует. Новые плагины — уже в разработке. И все бесплатные. Вот первый мой бесплатный плагин.

    Читай также: Почему я взял паузу в разработке и начал писать статьи

    Константин Милютин
    Автор блога «Милютин Код»

  • От идеи до попадания в самое большое хранилище плагинов! Сквозь боль и страдания

    От идеи до попадания в самое большое хранилище плагинов! Сквозь боль и страдания

    Если ты читал мои предыдущие статьи, то знаешь: я прошёл долгий путь от PHP-плагина к Python-скрипту, от бесконечных ошибок к работающей системе автопостинга новостей. Я переосмыслил стратегию блога, отказался от массовой генерации контента и решил создавать полезные инструменты.

    И вот — свершилось!

    Мой плагин «Milyutin Code Article Reposter for VK» официально опубликован в репозитории WordPress.org и доступен для скачивания:

    🔗 wordpress.org/plugins/milyutin-code-article-reposter-for-vk

    Это был долгий и сложный путь. Плагин переделывался с нуля несколько раз. Были моменты, когда я хотел всё бросить и думал, что я себя переоценил в умении общения с ИИ. Но сегодня я хочу рассказать эту историю — от идеи до попадания в самое большое хранилище плагинов в мире. Сквозь боль, страдания и бесконечные правки.

    Часть 1. Как начинались боль и страдания

    Когда я только задумал этот плагин, идея была простая: автоматически публиковать новые статьи из WordPress-блога в группу ВКонтакте. Чтобы не копировать текст вручную каждый раз. Чтобы подписчики видели анонс с картинкой и ссылкой.

    Я написал первую версию на PHP за пару вечеров. Она работала. Плагин брал статью, отправлял в YandexGPT для генерации краткого обзора, получал ответ и публиковал в ВК. Выглядит вроде всё просто.

    Но я решил пойти дальше. Я захотел выложить плагин в официальный репозиторий WordPress.org, чтобы любой владелец сайта мог установить его в один клик.

    И тут начались страдания и боль…

    Часть 2. Первая попытка: отказ и переименование

    Milyutin Code Article Reposter for VK
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я загрузил плагин на review. Через несколько дней пришло письмо от команды WordPress.org.

    Плагин назывался «VK AI Reposter». И это стало первой проблемой.

    «VK» — это зарегистрированный товарный знак третьей стороны, и его использование в начале названия может подразумевать официальную принадлежность к VK.

    Мне предложили переименовать плагин в «Milyutin Code Article Reposter for VK» — с моим именем в начале, чтобы чётко обозначить, что это неофициальный инструмент.

    Я согласился. Изменил название плагина на milyutin-code-article-reposter-for-vk.

    Но это было только начало.

    Часть 3. Технические требования: что пришлось переделывать

    боль и страдания
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Репозиторий WordPress.org — это не просто «залей и готово». Там строгие правила. И мой плагин их нарушал.

    Вот список того, что пришлось исправить:

    Подключение скриптов и стилей

    Вместо прямого вывода <script> и <style> в коде, нужно использовать wp_enqueue_script() и wp_enqueue_style(). Это стандарт WordPress для производительности и совместимости.

    Санитизация и экранирование

    Все данные, приходящие из $_GET$_POST$_REQUEST, нужно санитизировать. А все выходные данные — экранировать.

    Например, вместо _e('текст', 'domain') нужно использовать esc_html_e('текст', 'domain').

    Префиксы для всего

    Функции, классы, глобальные переменные, опции — всё должно иметь уникальный префикс, чтобы не конфликтовать с другими плагинами.

    Документирование внешних сервисов

    Плагин использует API ВКонтакте и YandexGPT. Это нужно чётко описать в readme.txt: какие данные отправляются, куда, зачем, и ссылки на политику конфиденциальности.

    Логирование в правильное место

    Я писал логи в папку плагина. Это запрещено. Логи нужно хранить в базе данных или в папке wp-content/uploads с защитой от прямого доступа.

    Не менять глобальные настройки PHP

    set_time_limit(120) на каждом запросе — плохая практика. Нужно ограничивать только те функции, где это действительно необходимо.

    Не использовать cURL напрямую

    Вместо curl_exec() нужно использовать WordPress HTTP API: wp_remote_get()wp_remote_post().

    Интернационализация

    Все строки должны быть обёрнуты в функции перевода, но без переменных в качестве текста или домена.

    Часть 4. Четыре раунда ревью

    боль и страдания
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Плагин проходил проверку четыре раза. Каждый раз находились новые ошибки. И с каждым разом надежда на то, что мой плагин опубликуют, угасала.

    • Раунд 1: проблемы с названием, документацией, скриптами, экранированием.

    • Раунд 2: битые ссылки на политику конфиденциальности Yandex.

    • Раунд 3: использование cURL вместо HTTP API и проблемы с экранированием nonce.

    • Раунд 4: финальные правки.

    И только после четвёртого раунда пришло письмо:

    Congratulations! The plugin was approved.

    Часть 5. Загрузка в репозиторий через SVN

    Milyutin Code Article Reposter for VK
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    После одобрения нужно было загрузить код через SVN.

    Я очистил локальную папку, сделал svn checkout, скопировал файлы в trunk, создал тег tags/1.0.0 и выполнил svn commit.

    Через несколько минут плагин появился в репозитории.

    Но это получилось со второго раза)

    Часть 6. Что умеет плагин сейчас

    Плагин «Milyutin Code Article Reposter for VK» автоматически публикует новые статьи из вашего блога в группу ВКонтакте.

    Возможности:

    • Автоматическая публикация — срабатывает при публикации поста.

    • Два источника для краткого анонса:

      • YandexGPT — генерирует краткий обзор с помощью нейросети (требуется API-ключ и это платно).

      • Первый абзац — берёт первый абзац статьи. Бесплатно и просто.

    • Загрузка изображений — автоматически находит и загружает обложку, изображение из Gutenberg-блока или первую картинку из контента.

    • Ручная публикация — в редакторе каждого поста есть кнопка «Опубликовать сейчас».

    • Логирование — все действия записываются в отдельный лог-файл, доступный в админке.

    Внешние сервисы:

    • VKontakte API — для публикации постов, загрузки фото и получения информации о группе.

    • Yandex GPT API — для генерации анонсов (опционально и платно).

    Плагин переведён на Английский и Русский языки.

    Часть 7. Что я понял за это время

    1. WordPress.org — это серьёзно.

    Там строгие правила. Но они существуют не для того, чтобы усложнить жизнь, а чтобы обеспечить безопасность и совместимость для миллионов пользователей.

    2. Каждая ошибка — это урок.

    Я никогда не думал о санитизации, экранировании и префиксах так глубоко, как за эти недели. Теперь я понимаю, почему это важно. И главное, теперь я научился писать промпты для ИИ с чётким техническим заданием, а не как писал, когда только начал создавать плагин.

    3. Не сдаваться.

    Были моменты, когда я хотел всё бросить. Но я продолжал. И это окупилось.

    4. Сообщество WordPress — это круто.

    Команда ревьюеров помогла мне сделать плагин лучше. Да, процесс был долгим и мучительным, но результат того стоил.

    Часть 8. Что дальше?

    Плагин уже доступен для скачивания. В планах:

    • Поддержка других социальных сетей (Telegram, ОК, Дзен).

    • Улучшение генерации анонсов.

    • Добавление пагинации и RSS-ленты для новостей.

    • Продолжение изучения SEO без плагинов (в ближайшее время проверю код на тестовом сайте и сразу же перенесу его на этот сайт).

    Призыв к действию

    Если ты тоже разрабатываешь плагин для WordPress — не бойся трудностей. Да, процесс публикации в официальный репозиторий может быть долгим и болезненным. Но это стоит того.

    🔗 Скачай плагин: wordpress.org/plugins/milyutin-code-article-reposter-for-vk

    Установи, настрой за 5 минут и забудь о ручном копировании постов в ВК.

    Боль и страдания Milyutin Code Article Reposter for VK
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Задавай вопросы, делись идеями, тестируй плагин. Вместе мы строим полезные инструменты!

    Продолжение следует. Идеи для новых плагинов — уже в разработке. И я рассматриваю способы, чтобы взять в помощники ChatGPT-4 для написания PHP кода.

    Читай также: Почему я взял паузу в разработке и начал писать статьи

    Константин Милютин
    Автор блога «Милютин Код»

  • Шестой день с DeepSeek: не забрасываю плагин — просто беру паузу, чтобы ускорить наполнение сайта

    Шестой день с DeepSeek: не забрасываю плагин — просто беру паузу, чтобы ускорить наполнение сайта

    Я работаю с DeepSeek. Если ты читаешь этот пост, значит, ты уже прошёл со мной путь от первой идеи до пятого дня, когда я осознал, что ошибка была не в коде, а в платном источнике новостей.

    Я честно признаюсь: PHP-плагин оказался сложнее, чем я думал. Я уже пять дней борюсь с багами, настройками, ошибками API и ограничениями хостинга. И хотя я исправил больше 20 проблем, плагин всё ещё не работает идеально.

    Но я не сдаюсь. И не забрасываю плагин на PHP.

    Я просто беру паузу, чтобы решить другую задачу: ускорить наполнение своего сайта новостями. А заодно — протестировать альтернативный подход. Потому что иногда правильнее сделать шаг назад, чтобы потом прыгнуть дальше.

    Если ты пропустил предыдущую часть, вот ссылка: Пятый день с DeepSeek: перерыв помог — я нашёл ошибку, и она оказалась совсем не в коде. А сейчас — мой шестой день, день стратегического решения и нового направления.

    Утро шестого дня: вопрос, который перевернул всё

    Я сидел и думал: «Плагин на PHP почти готов, но возни с ним ещё много. Может, есть способ быстрее начать публиковать новости?»

    Я открыл чат с DeepSeek и задал вопрос, который давно вертелся в голове:

    «Плагин на PHP не получается довести до ума, точнее я хочу довести до ума его, но много занимает времени. Может, реализовать автопостинг новостей по принципу как в плагине, но только через Python, если это проще?»

    DeepSeek ответил неожиданно честно: «Да, реализовать автопостинг на Python действительно проще». И объяснил почему.

    Почему Python проще, чем PHP-плагин?

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    DeepSeek сравнил две задачи:


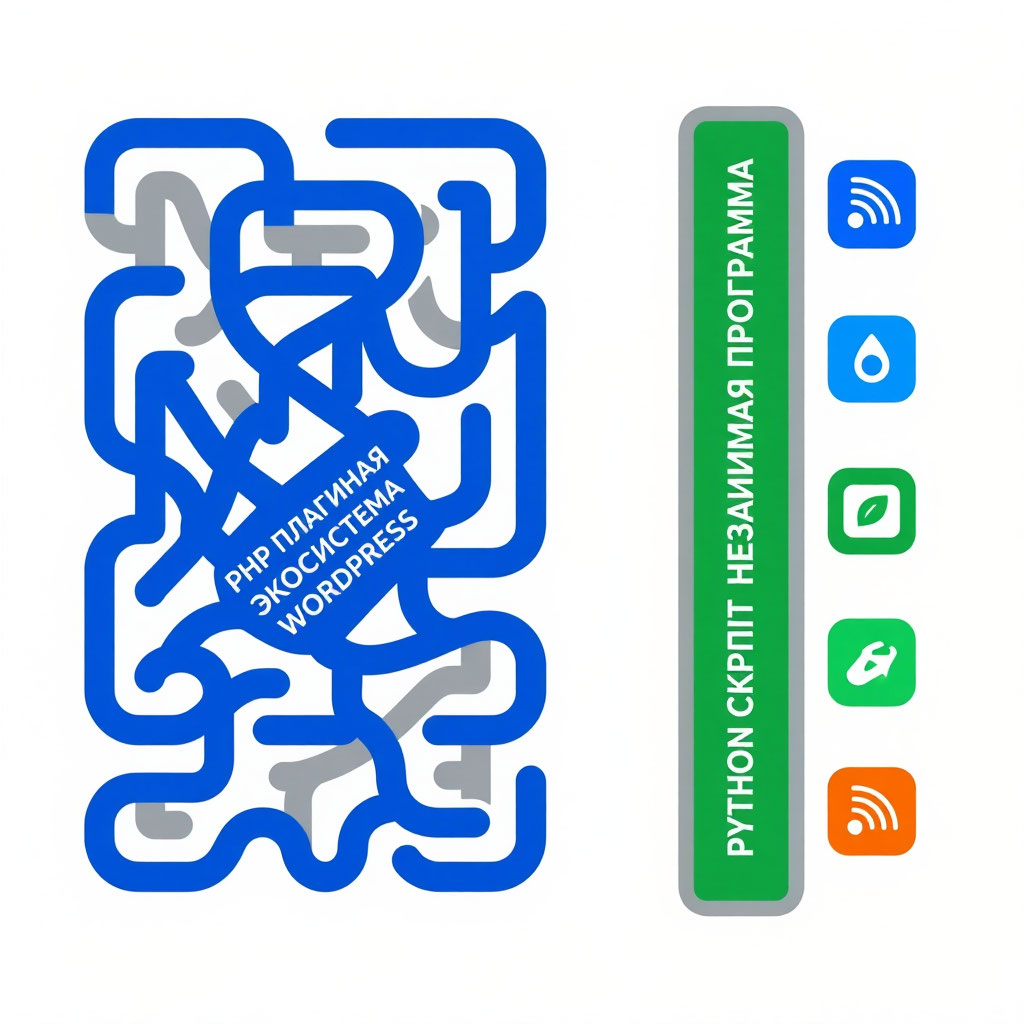
    PHP-плагин Python-скрипт
    Глубокое погружение в экосистему WordPress Независимая программа
    Требует знания хуков, фильтров, WP-Cron Просто общается с WordPress через REST API
    Код работает внутри системы — много ограничений Делает только то, что я ему скажу
    Сложно отлаживать Легко тестировать и изменять по частям

    И это действительно так. Python — идеальный выбор для задач автоматизации. Он позволяет создать гибкий пайплайн, который легко тестировать, модифицировать и запускать по расписанию.

    Что может делать Python-скрипт для автопостинга?

    DeepSeek перечислил ключевые возможности:

    • Парсить RSS и получать новости.

    • Переводить контент с английского на русский (через YandexGPT).

    • Обрабатывать текст (рерайт, генерация заголовка, тегов).

    • Генерировать изображения через YandexART.

    • Публиковать посты через WordPress REST API.

    • Работать по расписанию через cron на сервере.

    И самое главное — всё это можно сделать в виде независимого скрипта, который не зависит от архитектуры WordPress.

    Архитектура Python-решения

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

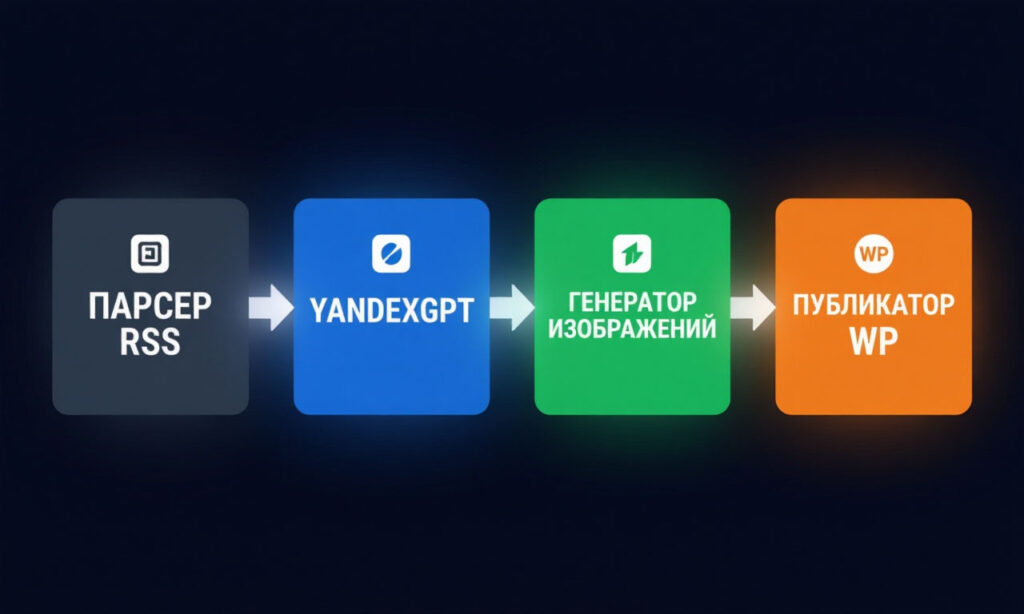
    DeepSeek предложил создать не один монолитный скрипт, а несколько независимых компонентов:

    • Скрипт-планировщик — запускается по cron каждый час.

    • Парсер — подключается к RSS-лентам и забирает новости.

    • Генератор — отправляет текст в YandexGPT и получает обработанный контент.

    • Публикатор — через WordPress REST API создаёт посты, назначает рубрики, теги и обложки.

    Такой подход гораздо более модульный. Если что-то сломается (например, изменится API Яндекса), я легко найду и исправлю проблему.

    Что я решил сделать

    PHP
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я не отказываюсь от PHP-плагина. Он останется как долгосрочное решение — полноценный инструмент, который будет жить внутри WordPress.

    Но сейчас, пока я довожу плагин до ума, я хочу быстро начать наполнять сайт новостями. Поэтому я решил:

    1. Создать Python-скрипт для автопостинга.

    2. Настроить его на работу с бесплатными RSS-источниками (Google News, The Verge, VentureBeat).

    3. Запустить его на VPS (выбрал Beget) по расписанию.

    4. Использовать его как временное решение, пока PHP-плагин не будет готов.

    Это даст мне:

    • Свежие новости на сайте каждый день.

    • Возможность тестировать разные форматы контента.

    • Понимание того, как работает автопостинг «снаружи» WordPress.

    • Опыт работы с Python, который пригодится в будущем.

    Какой продукт я купил на Beget

    Python
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Для запуска Python-скрипта мне нужен был не обычный хостинг, а VPS. На обычном хостинге:

    • время выполнения скриптов строго ограничено,

    • фоновые задачи работают нестабильно,

    • нельзя установить нужные версии Python и библиотеки.

    Я выбрал VPS на Beget с такой конфигурацией:

    • ОС: Ubuntu 22.04 LTS

    • Процессор: 2 ядра

    • Оперативная память: 4 ГБ

    • Диск: 40 ГБ NVMe

    Это стоит примерно 390–510 ₽ в месяц (плюс 150 ₽ за IPv4-адрес). Вполне приемлемо для стабильной работы скрипта.

    Что дальше?

    Python
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

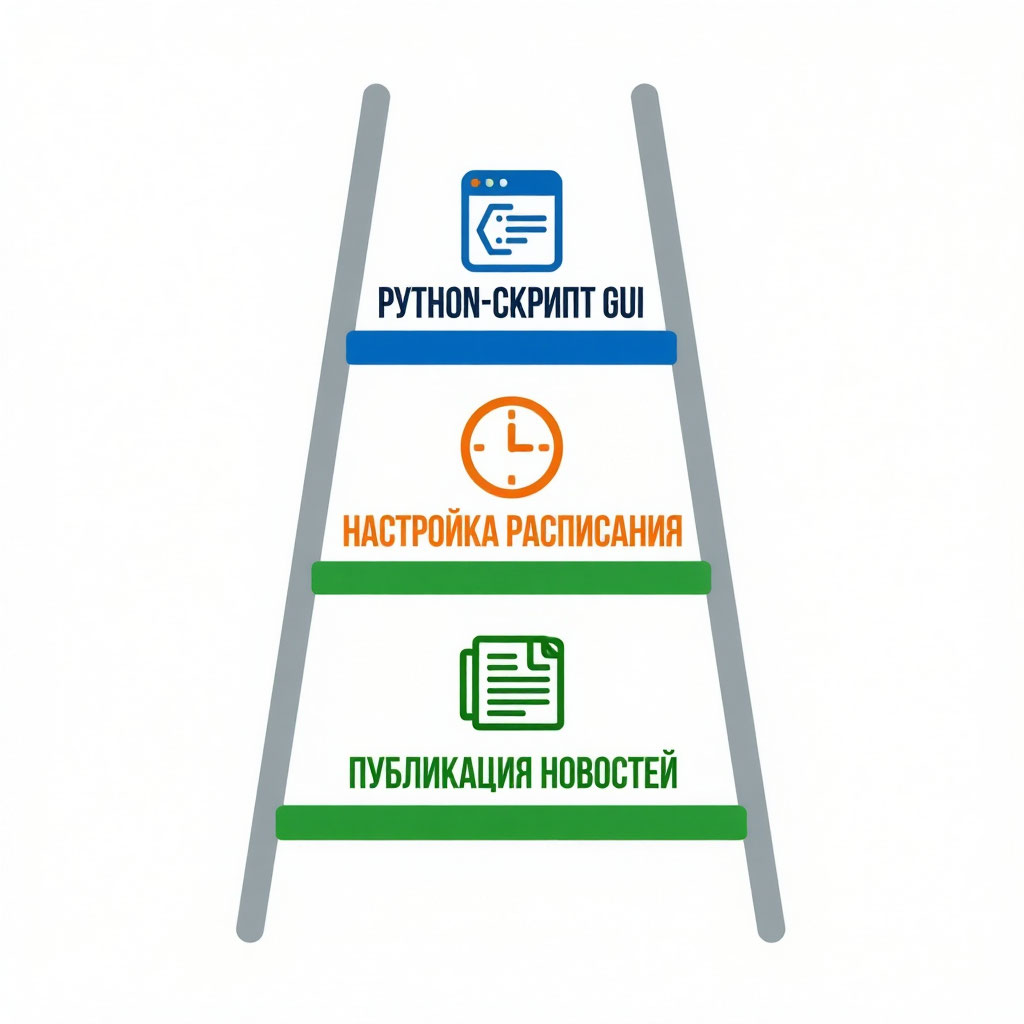
    Я уже подготовил подробный промпт для DeepSeek, который поможет мне создать Python-скрипт с графическим интерфейсом. В нём будут:

    • Удобные поля для ввода настроек (API-ключи, RSS-ссылки, email).

    • Кнопки «Запустить сейчас» и «Запустить по расписанию».

    • Поле для вывода логов в реальном времени.

    • Сохранение настроек в файл config.json.

    Как только скрипт будет готов, я начну публиковать новости на сайте автоматически.

    А PHP-плагин я продолжу дорабатывать в фоновом режиме. Он станет моим «взрослым» решением, когда я буду полностью уверен в его стабильности.

    Что я понял за шесть дней

    • Не обязательно выбирать что-то одно. Можно использовать два инструмента параллельно — временный и основной.

    • Python действительно проще для автоматизации. Иногда правильнее выйти за рамки экосистемы и сделать независимый скрипт.

    • VPS — это необходимость. Для фоновых задач и долгих процессов обычный хостинг не подходит.

    • Не нужно гнаться за результатом. Этот путь — долгий, и в нём есть место для обходных путей.

    • DeepSeek — не просто помощник, а стратег. Он помогает не только с кодом, но и с выбором правильного направления.

    Итог: я не забрасываю плагин — я беру паузу

    Плагин на PHP остаётся в разработке. Я вернусь к нему, когда у меня будет больше времени и сил. А пока я запускаю Python-скрипт, который будет автоматически наполнять сайт новостями.

    Это не отказ от мечты. Это стратегический манёвр.

    Если ты тоже разработчик-самоучка и иногда чувствуешь, что застрял — вспомни мою историю. Иногда правильнее не биться головой о стену, а найти обходной путь. Взять паузу. Сделать шаг назад, чтобы потом прыгнуть дальше.

    Подписывайся на мой блог, чтобы не пропустить следующую главу. Я расскажу, как создавал Python-скрипт с графическим интерфейсом и настраивал его на VPS.

    Контакты

    📧 Email: milyutinkv@gmail.com
    🌐 Сайт: milyutin-codes.ru
    💬 Группа ВК: vk.ru/milyutin_codes

    Задавай вопросы, делись идеями, пиши свои истории. Мы вместе.

    Продолжение следует. Теперь — с Python.

    Python
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Константин Милютин
    Автор блога «Милютин Код»


  • Пятый день с DeepSeek: перерыв помог — я нашёл ошибку, и она оказалась совсем не в коде

    Пятый день с DeepSeek: перерыв помог — я нашёл ошибку, и она оказалась совсем не в коде

    Я работаю с DeepSeek. Если ты читаешь этот пост, значит, ты уже прошёл со мной путь от первой идеи до четвёртого дня, когда я взял паузу, чтобы не сойти с ума. Я честно признался, что устал, что упёрся в стену, и мне нужно время, чтобы осмыслить происходящее.

    И знаешь что? Перерыв сработал.

    Я отвлёкся, выдохнул, переключился на другие дела. А когда через пару дней вернулся к коду, меня осенило. Ошибка была не в коде. Она была в том, откуда я беру новости.

    Если ты пропустил предыдущую часть, вот ссылка: Четвёртый день с DeepSeek: почти финиш, но я взял паузу. А сейчас — мой пятый день, день осознания и нового начала.

    Утро пятого дня: отдохнувший мозг видит яснее

    Я открыл чат с DeepSeek после перерыва и сказал: «Я понял. Плагин работает идеально на моём локальном сервере. Но на боевом хостинге он не может скачать RSS-ленту Technology Review. Я увеличивал таймауты, добавлял повторные попытки, кеширование — ничего не помогает».

    DeepSeek спросил: «А что, если проблема не в технической части? Может быть, сайт просто не отдаёт полный контент?»

    И тут меня осенило. Я зашёл на сайт Technology Review в обычном браузере и увидел это: замок. Статья требовала подписки. Полный текст был доступен только платным пользователям. RSS-лента отдавала только анонсы — те самые несколько предложений, которые я видел в постах.

    Всё это время я бился головой о стену, пытаясь исправить то, что нельзя исправить кодом. Ошибка была не в плагине. Ошибка была в источнике данных.

    Что я сделал за этот день

    Даже несмотря на осознание, что Technology Review — платный, я продолжил улучшать плагин. Потому что другие источники будут работать. И я хочу, чтобы плагин был готов к любым условиям.

    Окончательно починил сохранение настроек

    Настройки теперь сохраняются идеально. Я переделал class-settings.php так, что все поля в одной форме, вкладки — просто навигация. Галки не слетают. Никогда.

    Очистка контента — теперь идеальная

    Я добавил комплексную очистку: удаляю **###---, обратные кавычки, множественные пробелы, пробелы перед знаками препинания. Контент стал кристально чистым.

    php
    private function clean_markdown( $text ) {
        $patterns = [
            '/\*\*/', '/__/', '/#{2,}/', '/-{2,}/', '/\*{2,}/', '/_{2,}/', '/\s{2,}/', '/```/'
        ];
        $text = preg_replace( $patterns, ' ', $text );
        return trim( preg_replace( '/\s+/', ' ', $text ) );
    }

    Ключевик — теперь главная сущность

    Я добавил метод, который через GPT выделяет главную сущность: название продукта, имя человека, компанию. Больше никаких предлогов в ключевике.

    Ключевик в первом абзаце — естественно

    Теперь ключевик вставляется как часть предложения, выделяясь жирным, без лишних тире и двоеточий.

    Убрал принудительный H2

    Подзаголовки теперь генерируются GPT органично. Без штампов.

    Объём контента — 600–800 слов

    Увеличил max_tokens до 3000, добавил требование к объёму в промпт. Статьи стали полноценными.

    Ссылка на источник — только домен

    Вместо полного URL показываю technologyreview.com. Кратко и понятно.

    Дубли исключены

    Механизм запоминания ссылок работает надёжно. Каждая новость публикуется только один раз.

    Изображения из RSS — с повторными попытками

    Плагин ищет картинку в media:contentenclosure, или берёт первое img из контента. При ошибке — повторяет попытку.

    Кеширование RSS для устойчивости

    Я добавил кеширование RSS-ответа на 1 час через set_transient(). Если лента недоступна, плагин использует кеш.

    Перевод контента на русский

    Все промпты теперь содержат требование «на РУССКОМ языке». Контент стал полностью русскоязычным.

    Главное открытие: ошибка была в источнике, не в коде

    Когда я понял, что Technology Review — платный, я почувствовал облегчение. Потому что это означало, что мой плагин работает правильно. Он делал всё, что должен. Просто получал то, что ему отдавали.

    DeepSeek сразу предложил альтернативные бесплатные RSS-источники. Вот некоторые из них:

    DeepSeek рекомендовал начать с Google News — это бесплатно, стабильно и без подписки. Я так и сделал.

    Что я понял за пять дней

    • Перерыв — это инструмент. Когда я отвлёкся, мозг продолжал работать в фоновом режиме и нашёл решение.

    • Ошибка может быть не в коде. Иногда проблема в окружении, в источнике данных, в бизнес-логике.

    • Не нужно гнаться за результатом. Этот путь — долгий. И он того стоит.

    • DeepSeek — не просто помощник. Он стал моим напарником, который не даёт опустить руки.

    • Плагин работает. И он будет работать ещё лучше с правильными источниками.

    Плагин не работает идеально, но я на верном пути

    Плагин «Autonews Publisher» сейчас полностью готов к работе. Он:

    • сохраняет настройки,

    • парсит RSS,

    • очищает контент,

    • генерирует статьи через YandexGPT,

    • добавляет SEO,

    • подгружает изображения,

    • исключает дубли.

    Единственное, что осталось — выбрать правильные RSS-источники. И это уже не техническая проблема, а стратегическая.

    Что дальше?

    Я начну тестировать плагин с новыми источниками — Google News, The Verge, VentureBeat. Уверен, что результаты будут отличными.

    А ещё я продолжу писать этот дневник. Потому что даже после финала плагина — это история о том, как человек учится, ошибается, отдыхает и идёт дальше.

    Призыв к действию

    Если ты тоже разрабатываешь что-то сложное — не забывай про отдых. Иногда лучший способ решить проблему — отойти от неё. Дать себе время. Посмотреть на неё свежим взглядом.

    Подписывайся на мой блог, чтобы не пропустить следующую главу. Я почти у цели.

    Контакты

    📧 Email: milyutinkv@gmail.com
    🌐 Сайт: milyutin-codes.ru
    💬 Группа ВК: vk.ru/milyutin_codes

    Задавай вопросы, делись идеями, пиши свои истории. Мы вместе.

    Ключевая фраза

    Ошибка была не в коде — она была в источнике.

    Продолжение следует. Теперь — с новыми источниками.

    Константин Милютин
    Автор блога «Милютин Код»

  • Четвёртый день с DeepSeek: почти финиш, но я взял паузу, чтобы не сойти с ума.

    Четвёртый день с DeepSeek: почти финиш, но я взял паузу, чтобы не сойти с ума.

    Я работаю с DeepSeek. Если ты читаешь этот пост, значит, ты уже прошёл со мной путь от первой идеи до третьего дня отладки. Я создавал плагин «Autonews Publisher», ловил баги, исправлял ошибки, и сегодня — четвёртый день — я почти у цели. Почти.

    Но сегодня я хочу рассказать не только о том, как я решил ещё 11 проблем. Я хочу рассказать о том, почему я решил сделать перерыв. Потому что иногда, чтобы понять, где ошибка, нужно остановиться, выдохнуть и посмотреть на код свежим взглядом. Не гнаться за результатом, а принять, что этот путь — долгий. И это нормально.

    Если ты пропустил предыдущие части, вот ссылка: Третий день с DeepSeek. А сейчас — мой четвёртый день.

    Утро четвёртого дня: план и реалии для плагина

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я открыл чат с DeepSeek и сказал: «Давай подведём итог. Что мы сделали, что осталось, и где мы сейчас?» Я уже исправил 13 ошибок в третий день, но оставались ещё нюансы: маркдаун-символы в тексте, слишком длинные URL, ключевики с предлогами, дубли новостей и, самое обидное, таймауты при подключении к RSS-лентам.

    DeepSeek снова взялся за работу. Я систематизировал все задачи и пошёл по списку. Вот что я сделал за этот день.

    Что я исправил в четвёртый день с DeepSeek

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    1. Сохранение настроек — окончательно и бесповоротно

    Настройки больше не слетают. Я переделал class-settings.php так, что все поля теперь в одной форме, а вкладки — просто навигация. При сохранении отправляются все данные, галки не сбрасываются. Теперь я могу спокойно переключаться между вкладками и не бояться, что что-то потеряется.

    2. Очистка контента от маркдаун-символов

    В статьях появлялись артефакты: **##---, лишние пробелы, даже буква «с» в начале. DeepSeek написал метод clean_markdown(), который удаляет всё это безобразие.

    php
    private function clean_markdown( $text ) {
        $patterns = [
            '/\*\*/', '/__/', '/#{2,}/', '/-{2,}/', '/\*{2,}/', '/_{2,}/', '/\s{2,}/'
        ];
        $text = preg_replace( $patterns, ' ', $text );
        return trim( preg_replace( '/\s+/', ' ', $text ) );
    }

    Теперь контент выглядит как полноценная статья, а не черновик из редактора.

    3. Корректное формирование фокусного ключевика

    Раньше ключевик обрезался до предлогов: «Искусственный интеллект в». DeepSeek предложил метод, который отсекает предлоги и союзы, оставляя только значимые слова — существительные и прилагательные. Теперь ключевик звучит осмысленно, например: «Искусственный интеллект разработка лекарств».

    4. Ключевик в первом абзаце — без лишних символов

    Раньше я вставлял ключевик с тире и двоеточием, что выглядело неестественно. Теперь он встраивается как часть предложения, выделяясь жирным шрифтом. Читабельно и без мусора.

    5. Убрал принудительный H2

    Я раньше добавлял искусственный подзаголовок «КЛЮЧЕВИК: ключевые аспекты», и это выглядело странно. Теперь я полагаюсь на GPT: в промпте рерайта я прошу нейросеть добавлять подзаголовки с ключевиком органично. Получается естественно и без штампов.

    6. Увеличил объём контента до 600+ слов

    Статьи были короткими — около 500 слов. Я увеличил max_tokens до 3000 и добавил в промпт требование «не менее 600 слов». Теперь GPT выдаёт статьи на 600–800 слов, что хорошо для SEO.

    7. Сократил постоянную ссылку (slug)

    URL был длиной 96 символов — слишком много. Я обрезаю slug до 60 символов и удаляю лишние окончания. Теперь ссылки аккуратные.

    8. Ссылка на источник — только домен

    Вместо полного URL я показываю только домен: technologyreview.com. Кратко и понятно.

    9. Предотвратил дублирование новостей

    Плагин больше не публикует одну и ту же новость дважды. Я добавил механизм, который запоминает ссылки опубликованных постов в опции autonews_published_links. Перед публикацией проверяю, не было ли уже этой ссылки.

    10. Извлечение изображений из RSS

    Теперь, если генерация картинок отключена, плагин ищет изображение в RSS: в media:content, в enclosure, или берёт первое img из контента. И устанавливает его как обложку с ALT = фокусный ключевик.

    11. Увеличен таймаут для RSS

    Но вот тут я упёрся в стену. Хостинг не даёт подключиться к www.technologyreview.com — таймаут 10 секунд. Я увеличил таймаут до 60 секунд, добавил повторные попытки (до 3-х с паузой 3 секунды), установил User-Agent. Но проблема не в коде. Она в хостинге.

    Не решённая проблема: хостинг блокирует RSS

    deepseek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я сделал всё, что мог. Код плагина готов. Он работает локально, на тестовом сервере — идеально. Но на боевом хостинге, где я размещаю свой сайт, исходящие соединения на порт 443 ограничены. Это значит, что плагин не может скачать RSS-ленту.

    DeepSeek предложил обратиться в поддержку хостинга с просьбой:

    • разрешить внешние HTTP-запросы,

    • увеличить max_execution_time до 120 секунд,

    • отключить ограничения allow_url_fopen.

    Но это требует времени. И я принял решение: не гнаться за результатом.

    Почему я решил сделать перерыв

    deepseek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Когда ты 4 дня подряд сидишь с кодом, общаешься с нейросетью, правишь баги, тестируешь, и на финишной прямой упираешься в стену — легко выгореть. Я понял, что если буду давить дальше, то перестану получать удовольствие от процесса. А ведь именно ради удовольствия я и начал этот проект.

    Я решил взять паузу. На пару дней отвлечься, переключиться, дать мозгу переварить информацию. Потому что иногда, чтобы найти решение, нужно отойти от задачи. Посмотреть на неё свежим взглядом. Осмыслить.

    Это не поражение. Это зрелость.

    Что я понял за четыре дня

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru
      • Плагин почти готов. Код работает, SEO-ошибки исправлены, контент очищен, дубли исключены. Осталось только решить вопрос с хостингом.

      • DeepSeek — мой идеальный напарник. За четыре дня я с DeepSeek исправил более 20 ошибок. Без него я бы просто не справился.

      • Нельзя игнорировать внешние ограничения. Иногда проблема не в твоём коде, а в окружении. И это нужно принимать.

      • Перерыв — это не слабость. Это способ сохранить ясность ума и не потерять интерес.

      • Этот путь — долгий. И это нормально. Главное — идти вперёд, даже если с остановками.

      Итоговый статус

      • Код: полностью готов к работе.

      • SEO: все ошибки исправлены.

      • Контент: очищен, объёмный, структурированный.

      • Дубли: исключены.

      • Изображения: подгружаются из RSS.

      • Единственная проблема: хостинг блокирует доступ к RSS-источникам.

      Как только хостинг снимет ограничения, плагин заработает в полную силу. Но я не тороплюсь. Я сделаю перерыв, осмыслю всё, что сделал, и вернусь с новыми силами.

      Что дальше?

      Я напишу отдельный пост о решении проблемы с хостингом, когда оно появится. А пока — отдыхаю, читаю, вдохновляюсь. И ты делай так же, если чувствуешь, что устал.

      Призыв к действию

      Если ты тоже разрабатываешь что-то сложное — не забывай про себя. Не гонись за результатом любой ценой. Иногда лучший шаг вперёд — это шаг назад, чтобы разогнаться.

      Подписывайся на мой блог, чтобы не пропустить продолжение. Я вернусь к плагину, когда буду готов.

      Контакты

      📧 Email: milyutinkv@gmail.com
      🌐 Сайт: milyutin-codes.ru
      💬 Группа ВК: vk.ru/milyutin_codes

      Задавай вопросы, делись идеями, пиши свои истории. Мы вместе.

      Продолжение следует. Но сначала — пауза.

    Константин Милютин
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Константин Милютин
    Автор блога «Милютин Код»


  • Третий день с DeepSeek: как мы победили 13 ошибок и приблизились к идеалу

    Третий день с DeepSeek: как мы победили 13 ошибок и приблизились к идеалу

    Если ты следишь за моим блогом, тознаешь: я с DeepSeek уже второй день борюсь с плагином «Autonews Publisher». Первый день я создавал архитектуру, второй — ловил баги с сохранением настроек и ошибкой 404. А сегодня… сегодня я разобрал 13 ошибок! Тринадцать! И каждая из них была маленьким кирпичиком в стене, которую я упорно разбирал, чтобы построить работающий инструмент.

    И да, плагин всё ещё не идеален. Но я на верном пути — и это главное. Сегодня я расскажу, как я с DeepSeek исправлял каждую проблему, какие решения находил и чему научился за этот продуктивный день.

    Если ты не читал предыдущие части, вот ссылка: Второй день с DeepSeek. А сейчас — погнали!

    Утро третьего дня: список задач

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я открыл чат с DeepSeek и сказал: «Сегодня я проделал большую работу по исправлению ошибок. Давай систематизируем их для отчёта». И я начал перебирать каждую проблему, которую обнаружил за предыдущие дни. Их оказалось 13. Тринадцать! Некоторые — крошечные, как лишние звёздочки в тексте, другие — серьёзные, как дублирование постов или неработающий Rank Math.

    Но вместо паники я почувствовал азарт. Каждая ошибка — это вызов, а с DeepSeek любой вызов превращается в увлекательное расследование. Я взял список и пошёл по пунктам.

    1. Настройки слетали — галки не сохранялись

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Проблема. Когда я сохранял настройки на одной вкладке, галки на других вкладках сбрасывались. Это происходило потому, что каждая вкладка отправляла только свои поля, и при сохранении они затирали остальные.

    Решение. DeepSeek предложил переписать sanitize_settings() так, чтобы он сохранял ВСЕ поля, даже те, которые не были переданы в запросе. Для чекбоксов, если галка отсутствует, мы явно ставим 0. Для остальных — берём старые значения или дефолтные.

    php
    foreach ( self::$fields as $key => $field ) {
        if ( array_key_exists( $key, $input ) ) {
            $value = $input[ $key ];
        } else {
            if ( $field['type'] === 'checkbox' ) {
                $value = 0; // отсутствие галки = 0
            } else {
                $value = isset( $old[ $key ] ) ? $old[ $key ] : $field['default'];
            }
        }
        // валидация и сохранение
    }

    Теперь настройки сохраняются все и сразу. Магия!

    2. RSS-источники не добавлялись / исчезали

    Проблема. Я добавлял RSS-ленту через кастомную форму, но после сохранения других вкладок список обнулялся. Виновник — стандартная кнопка «Сохранить» на вкладке RSS, которая отправляла пустой массив.

    Решение. Я убрал стандартную кнопку на вкладке RSS и оставил только кастомное управление. Теперь добавление и удаление происходит напрямую через update_option(), без лишних сохранений.

    php
    if ( $active_tab === 'rss' ) {
        $this->render_rss_tab(); // без стандартной формы
    }

    И вот, RSS-источники стали жить своей жизнью — стабильной и предсказуемой.

    3. Ошибка 404 при запросе к YandexGPT

    Проблема. При тестовом запуске плагин падал с ошибкой 404. Причина — устаревший URL https://llm.api.cloud.yandex.net/llm/v1alpha/instruct. Яндекс обновил API, и старый эндпоинт перестал работать.

    Решение. DeepSeek нашёл актуальный URL https://llm.api.cloud.yandex.net/foundationModels/v1/completion и обновил формат запроса на messages с ролями system и user.

    php
    private $api_url = 'https://llm.api.cloud.yandex.net/foundationModels/v1/completion';
    $body = array(
        'modelUri' => 'gpt://' . $this->folder_id . '/yandexgpt-lite',
        'messages' => array(
            array( 'role' => 'system', 'text' => $system_instruction ),
            array( 'role' => 'user', 'text' => $user_text ),
        ),
    );

    Теперь YandexGPT отвечает как часы.

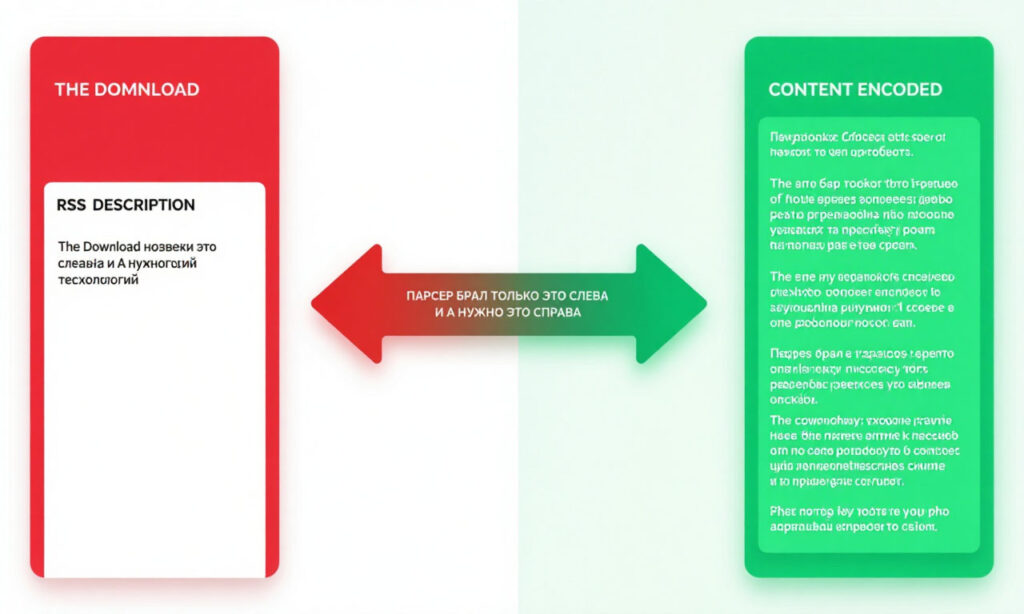
    4. Парсер брал только краткое описание, а не полный текст

    Проблема. В статьях появлялись только первые два предложения, а не весь текст. Парсер брал <description>, а не <content:encoded>.

    Решение. Я изменил приоритет полей: сначала ищем content:encoded, потом descriptioncontentsummary.

    php
    if ( isset( $item->children( 'http://purl.org/rss/1.0/modules/content/' )->encoded ) ) {
        $content = (string) $item->children( 'http://purl.org/rss/1.0/modules/content/' )->encoded;
    } elseif ( isset( $item->description ) ) {
        $content = (string) $item->description;
    }

    Теперь статьи выходят полными — от заголовка до последнего абзаца.

    5. В контенте оставались символы **

    Проблема. В тексте встречались **, которые, видимо, были маркерами выделения в оригинальном RSS.

    Решение. Просто удаляю их через str_replace().

    php
    $new_content = str_replace( '**', '', $new_content );

    Чистота!

    6. Заголовок содержал кавычки и многоточие

    Проблема. Заголовки выглядели неряшливо: кавычки, лишние точки.

    Решение. Удаляю все виды кавычек, обрезаю до 60 символов, но так, чтобы не обрезать слово посередине.

    php
    $new_title = str_replace( ['«', '»', '"', "'", '“', '”'], '', $new_title );
    if ( mb_strlen( $new_title ) > 60 ) {
        $new_title = mb_substr( $new_title, 0, 60 );
        $new_title = preg_replace( '/\s+\S*$/', '', $new_title );
    }

    Теперь заголовки — как на подбор.

    7. Ссылка на источник отображалась полным URL

    Проблема. В посте появлялось https://www.technologyreview.com/..., что выглядело громоздко.

    Решение. Извлекаю только домен, без www.

    php
    $host = parse_url( $source_url, PHP_URL_HOST );
    $display_host = str_replace( 'www.', '', $host );
    $link_html = '<a href="' . esc_url( $source_url ) . '" rel="nofollow">' . esc_html( $display_host ) . '</a>';

    Коротко и ясно.

    8. SEO-ошибки: фокусный ключевик отсутствовал в первом абзаце, H2 и URL

    Rank Math
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Проблема. Rank Math ругался, что ключевое слово не встречается в первых 100 словах, нет подзаголовков с ключевиком, и URL не содержит ключа.

    Решение. Я вставил ключевик в первый абзац (если его там не было), добавил H2 с ключевиком, и сформировал slug из заголовка.

    php
    // Вставляем в первый абзац
    if ( stripos( $first_p, $focus_keyword ) === false ) {
        $new_first_p = '<p><strong>' . $focus_keyword . '</strong> — ' . $first_p . '</p>';
    }
    // Добавляем H2
    if ( stripos( $content, '<h2' ) === false ) {
        $content = '<h2>' . $focus_keyword . ': ключевые аспекты</h2>' . $content;
    }
    // Формируем slug
    $slug = sanitize_title( $new_title );

    Теперь SEO-показатели должны улучшиться.

    9. Контент был слишком коротким (<600 слов)

    Проблема. YandexGPT выдавал статьи по 300–400 слов, а хотелось минимум 600.

    Решение. Я изменил промпт для нейросети, добавив явное требование к объёму.

    php
    $system = '... Постарайся создать статью объёмом не менее 600 слов, но не более 800 слов. Разбей текст на абзацы, используй подзаголовки (H2, H3).';

    Теперь статьи стали объёмными и структурированными.

    10. Плагин публиковал одну и ту же новость несколько раз

    YandexGPT
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Проблема. При каждом запуске плагин публиковал уже опубликованные новости, создавая дубли.

    Решение. Я добавил механизм запоминания ссылок в отдельной опции autonews_published_links. Перед публикацией проверяем, не была ли ссылка уже использована.

    php
    private $published_links_key = 'autonews_published_links';
    private function is_already_published( $link ) {
        $published = get_option( $this->published_links_key, array() );
        return in_array( $link, $published );
    }
    private function mark_as_published( $link ) {
        $published = get_option( $this->published_links_key, array() );
        if ( ! in_array( $link, $published ) ) {
            $published[] = $link;
            update_option( $this->published_links_key, $published );
        }
    }

    Дублей больше нет!

    11. Изображение не извлекалось из RSS

    Проблема. В статьях не было обложек, хотя в RSS-ленте они были.

    Решение. DeepSeek написал метод extract_image(), который ищет картинку в трёх местах: media:contentenclosure (если это изображение), или первое изображение в HTML-контенте.

    php
    private function extract_image( $item, $content ) {
        // media:content
        if ( isset( $item->children( 'http://search.yahoo.com/mrss/' )->content ) ) { ... }
        // enclosure
        if ( isset( $item->enclosure ) && strpos( $type, 'image/' ) === 0 ) { ... }
        // первое изображение в HTML
        if ( preg_match( '/<img[^>]+src=["\']([^"\']+)["\']/i', $html, $matches ) ) { ... }
    }

    Теперь каждая статья получает обложку.

    12. Ошибка соединения при тестовом запуске — не было логов

    Проблема. Иногда тестовый запуск падал с непонятной ошибкой, но в логах ничего не было.

    Решение. Я добавил логи перед каждым вызовом YandexGPT, чтобы отследить, на каком именно шаге происходит сбой.

    php
    $this->logger->log( 'Перед генерацией заголовка', 'info' );
    $new_title = $this->gpt->generate_title( $raw_title );
    $this->logger->log( 'После генерации заголовка', 'info' );

    Теперь я вижу, где именно плагин спотыкается.

    13. Rank Math заполнялся некорректно — описание без ключевика, заголовок с %sitename%

    Проблема. В SEO-полях Rank Math было пустое описание или заголовок с лишним %sitename%.

    Решение. Я убрал %sitename% из заголовка и добавил ключевик в описание, если его там не было.

    php
    $seo_title = str_replace( '%sitename%', '', $seo_title );
    if ( $focus_keyword && stripos( $description, $focus_keyword ) === false ) {
        $description = $focus_keyword . ' — ' . $description;
    }

    Итог: что я исправил сегодня

    YandexGPT
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    После моего марафона были обновлены следующие файлы:

    • autonews-publisher.php – добавлен AJAX-обработчик и проверка включения.

    • includes/class-settings.php – полная переработка сохранения, одна форма, вкладки-навигация.

    • includes/class-rss-fetcher.php – извлечение полного контента, очистка от рекламы, поиск изображения.

    • includes/class-yandex-gpt.php – обновлённый URL, формат, промпт на 600+ слов.

    • includes/class-publisher.php – предотвращение дублей, SEO-оптимизация, ссылка-домен, заголовок без кавычек.

    • includes/class-cron.php – проверка включения плагина.

    • assets/js/admin.js – AJAX для тестовой кнопки.

    Плагин стал значительно стабильнее. Он сохраняет настройки, парсит RSS, генерирует контент через YandexGPT, создаёт посты с SEO-полями, изображениями и без дублей. Да, он всё ещё не идеален — иногда изображения не загружаются, иногда теги генерируются не совсем точно. Но я на верном пути.

    Чему я научился в третий день

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru
      • Системный подход — когда у тебя 13 ошибок, важно не паниковать, а разбирать их по одной, от простых к сложным.

      • DeepSeek — гениальный напарник — он не просто даёт код, он объясняет логику, предлагает альтернативы, помогает увидеть картину целиком.

      • Отладка — это творчество — каждая ошибка — это загадка, а её решение — маленькая победа.

      • SEO-оптимизация требует внимания — даже если контент хорош, без правильного ключевика в нужных местах его не увидят.

      • Дубли — зло — механизм запоминания ссылок должен быть в любом парсере.

      Что дальше?

      Плагин почти готов. Осталось отладить генерацию изображений через YandexART, добавить поддержку нескольких языков и, возможно, сделать веб-интерфейс для ручного запуска. Но основа уже есть — и она работает.

      Я продолжу вести дневник разработки, чтобы ты видел весь путь — от первой строки кода до готового продукта.

      Призыв к действию

      Если ты тоже разрабатываешь что-то сложное и боишься ошибок — не бойся. Ошибки — это часть пути. С DeepSeek ты никогда не останешься один на один с проблемой. Он поможет, подскажет, объяснит.

      Подписывайся на мой блог, чтобы не пропустить следующую статью — в ней я расскажу, как я наконец-то запустил плагин в боевом режиме.

      Контакты

      📧 Email: milyutinkv@gmail.com
      🌐 Сайт: milyutin-codes.ru
      💬 Группа ВК: vk.ru/milyutin_codes

      Задавай вопросы, делись идеями, давай расти вместе.

      Продолжение следует. Я приближаюсь к финалу.

      Константин Милютин

  • Второй день с DeepSeek: как мы ловили баги в плагине и нашли верный путь

    Второй день с DeepSeek: как мы ловили баги в плагине и нашли верный путь

    Как я за второй день разработки починил сохранение настроек, победил ошибку 404 и научил парсер читать полные статьи

    В прошлой статье я рассказывал, как мы с DeepSeek создали плагин для WordPress, который выглядит идеально — но пока не работает. Ошибка за ошибкой, шаг за шагом я приближался к цели. Сегодня расскажу о втором дне разработки.

    Спойлер: плагин всё ещё не идеален. Но я на верном пути.

    С чего я начал второй день

    день с DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    После первой статьи я был полон оптимизма. Плагин «Autonews Publisher» уже имел красивую админку, восемь вкладок настроек, интеграцию с YandexGPT и YandexART. Но при попытке сохранить настройки — они слетали. При попытке опубликовать новость — падала ошибка 404 от YandexGPT. И самое обидное: RSS-источники, которые я добавлял, исчезали после сохранения других вкладок.

    Я открыл чат с DeepSeek и сказал: «Нашёл ошибку. Плагин не сохраняет настройки в полях API ключ YandexGPT, Folder ID Yandex, Рубрика для публикации, Email для уведомлений. Ещё надо добавить функцию включить плагин и тестовый запуск».

    DeepSeek сразу взялся за дело. Он предложил исправить метод sanitize_settings() так, чтобы он не затирал поля, которые не были отправлены формой. Вместо этого — сливать новые значения со старыми. И это сработало! Настройки перестали слетать.

    Но проблема с RSS-источниками осталась. Каждый раз, когда я сохранял настройки на любой другой вкладке, список RSS-лент обнулялся. DeepSeek предложил убрать стандартную кнопку «Сохранить» с вкладки RSS и оставить только кастомное управление через кнопки «Добавить» и «Удалить». Я сделал так, чтобы RSS-источники сохранялись отдельно, и теперь они перестали исчезать.

    Ошибка 404: почему YandexGPT не отвечал

    день с DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Следующая проблема была серьёзнее. При тестовом запуске плагин создавал пост, но в логах появлялась ошибка:

    text
    Ошибка YandexGPT (код 404): request-id: 758cf93c-168e-4db6-8c34-7618c77ae16a

    DeepSeek быстро нашёл причину: я использовал устаревший URL https://llm.api.cloud.yandex.net/llm/v1alpha/instruct. За прошедшие месяцы Yandex Cloud обновил API, и теперь нужно использовать https://llm.api.cloud.yandex.net/foundationModels/v1/completion. Кроме того, изменился формат запроса: вместо полей instruction и text теперь используется массив messages с ролями system и user.

    DeepSeek переписал метод request() в классе Autonews_Yandex_GPT:

    php
    $body = array(
        'modelUri' => 'gpt://' . $this->folder_id . '/yandexgpt-lite',
        'completionOptions' => array(
            'stream' => false,
            'temperature' => $this->temperature,
            'maxTokens' => $this->max_tokens,
        ),
        'messages' => array(
            array(
                'role' => 'system',
                'text' => $system_instruction,
            ),
            array(
                'role' => 'user',
                'text' => $user_text,
            ),
        ),
    );

    После замены файла ошибка 404 исчезла. Но на её месте появилась другая проблема: парсер RSS извлекал только краткое описание новости, а не полный текст.

    Почему в статье было только вступление

    день с DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я добавил RSS-ленту MIT Technology Review и запустил тест. Плагин опубликовал статью, но в ней было всего несколько строк:

    «The Download: новости технологий. Здравствуйте! В сегодняшнем выпуске The Download мы расскажем о том, что происходит в мире технологий…»

    А полная статья была огромной! Я открыл оригинал: https://www.technologyreview.com/2026/07/20/1140675/chinas-ai-models-have-trumps-ai-world-at-war-with-itself/

    DeepSeek объяснил: в RSS-ленте есть два типа контента — краткое описание (<description>) и полный HTML (<content:encoded>). Мой парсер брал только description, потому что он стоял в приоритете. Нужно было изменить порядок: сначала искать content:encoded, а только потом description.

    DeepSeek переписал метод fetch() в классе Autonews_RSS_Fetcher:

    php
    if ( isset( $item->children( 'http://purl.org/rss/1.0/modules/content/' )->encoded ) ) {
        $content = (string) $item->children( 'http://purl.org/rss/1.0/modules/content/' )->encoded;
    } elseif ( isset( $item->description ) ) {
        $content = (string) $item->description;
    }

    Теперь парсер стал брать полный текст. Но вместе с текстом приходила реклама, баннеры и скрипты. Нужно было очистить контент.

    Чистка контента от рекламы с сохранением ссылок

    день с DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

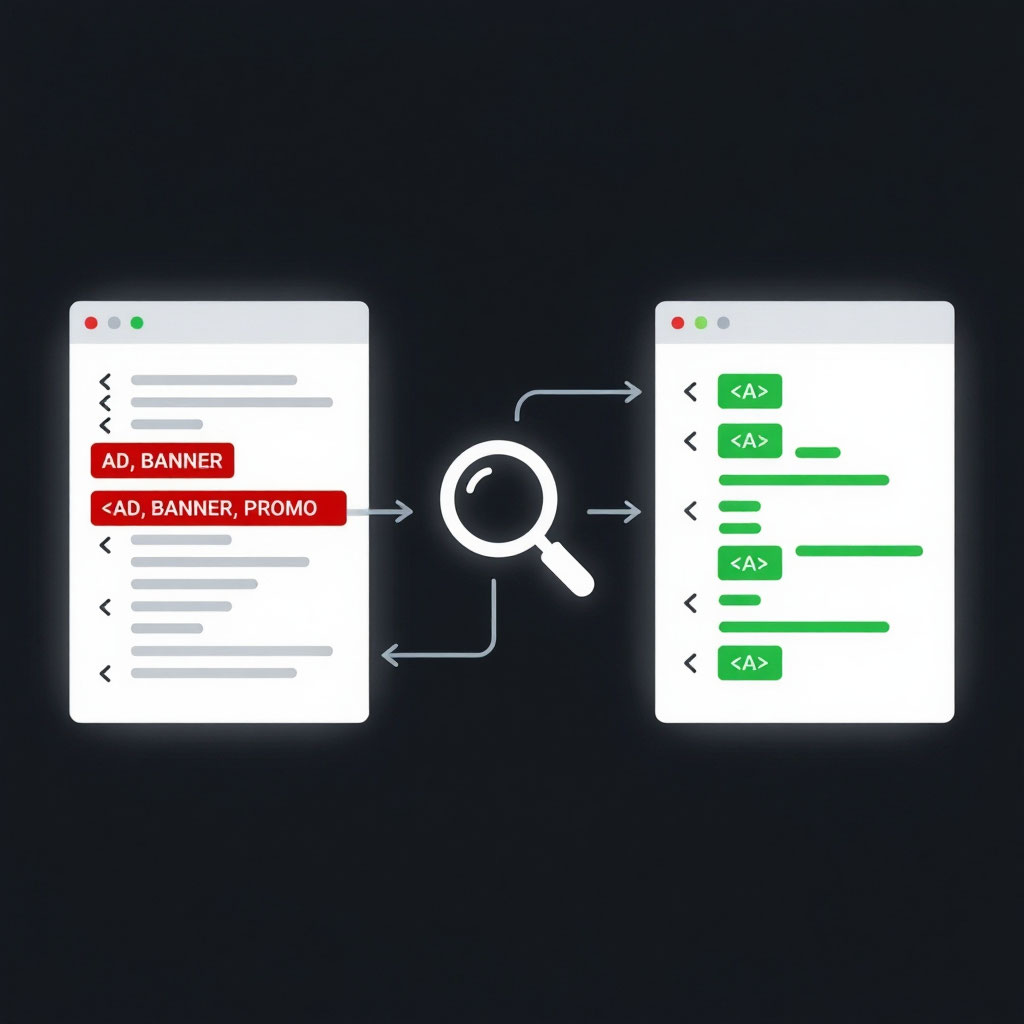
    DeepSeek написал метод clean_content(), который:

    • Удаляет элементы с классами adbannerpromosponsoradvertisement и другими рекламными индикаторами.

    • Удаляет все <script><iframe><style><noscript>.

    • Сохраняет ссылки <a> и полезные теги (абзацы, заголовки, списки).

    Теперь каждая статья выходила чистой, без мусора, но с живыми ссылками на первоисточник.

    Что я получил в итоге

    день с DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    На второй день разработки плагин:

    • Сохраняет все настройки без сбросов.

    • RSS-источники больше не исчезают.

    • YandexGPT отвечает без ошибки 404.

    • Парсер извлекает полный текст статьи.

    • Контент очищается от рекламы и скриптов.

    Пост #1000 был создан успешно! В нём была полная статья, очищенная от рекламы, но со ссылками.

    Плагин всё ещё не идеален, но я на верном пути

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Да, плагин ещё не готов к релизу. Есть нюансы с форматированием, иногда теряются изображения, не всегда корректно определяются теги. Но я с DeepSeek иду в правильном направлении. Каждая исправленная ошибка — это шаг вперёд.

    Я понял главное: даже когда кажется, что всё сломалось, нейросеть-наставник помогает разобраться. DeepSeek не просто даёт код — он объясняет почему это работает, откуда берутся ошибки и как их чинить.

    Уроки второго дня

    1. Настройки нужно мержить, а не перезаписывать. Если форма отправляет только часть полей, остальные должны оставаться на месте.

    2. API нейросетей меняются. То, что работало вчера, сегодня может устареть. Всегда проверяйте актуальную документацию.

    3. RSS-парсер должен уметь извлекать content:encoded. Краткое описание — это не полный текст.

    4. Очистка контента — это отдельная наука. Нужно удалять рекламу, но сохранять ссылки.

    5. DeepSeek — лучший напарник. Он терпеливо объясняет, предлагает решения и не устаёт от моих вопросов.

    Что дальше?

    В следующей статье я расскажу, как буду настраивать генерацию изображений через YandexART, улучшать SEO-заполнение и добавлять поддержку нескольких языков. Ошибки ещё будут, но я знаю: с DeepSeek я справлюсь.

    Призыв к действию

    Если ты читаешь это и думаешь, что программирование — это сложно и не для тебя, вспомни мою историю. Я начинал с G-кода на станках с ЧПУ, работал менеджером по запчастям, вожу такси. Но я не боюсь ошибаться, потому что каждая ошибка — это урок. И если у меня получается, то у тебя получится тем более.

    Подписывайся на блог, задавай вопросы, делись опытом. Вместе мы пройдём этот путь.

    Контакты

    📧 Email: milyutinkv@gmail.com
    🌐 Сайт: milyutin-codes.ru
    💬 Группа ВК: vk.ru/milyutin_codes

    Продолжение следует. Я ещё не закончил, но я уже близко.

    Константин Милютин
    Автор блога «Милютин Код»

  • Как DeepSeek помог мне создать плагин, который выглядит на миллион… но пока не работает (и это нормально)

    Как DeepSeek помог мне создать плагин, который выглядит на миллион… но пока не работает (и это нормально)

    Последние несколько дней я почти не выходил из-за компьютера. Писал плагин для WordPress, который должен автоматически собирать новости из RSS, переписывать их через нейросети, генерировать картинки и публиковать на сайт. С помощью DeepSeek я набросал почти 2000 строк кода, настроил структуру, вкладки, формы, интеграцию с API YandexGPT и YandexART. Всё выглядит идеально. Меню в админке — как у топовых плагинов. Логи пишутся, настройки сохраняются, cron-задача планируется. Красота!

    Но есть нюанс. Проверить работоспособность я пока не могу — ошибка. Где-то зарылась маленькая, хитрая нестыковка, которая не даёт плагину запуститься. И знаешь? Я не расстраиваюсь. Наоборот — это самое интересное! Мы с DeepSeek уже начали охоту на баг, и она обещает быть увлекательной.

    Сегодня расскажу, как создавался этот плагин, почему я в восторге от результата, даже несмотря на ошибку, и какую интригу оставим для следующей статьи.


    Откуда взялась идея и почему DeepSeek

    Я веду блог milyutin-codes.ru, где делюсь кодом, мыслями и ошибками. Но вести блог — полдела. Нужно публиковать свежие новости, чтобы сайт был живым. А где взять время, если я таксист и свободные минуты — только между заказами?

    Я решил автоматизировать рутину: пусть машина собирает новости из RSS, переписывает их (чтобы не было копипаста), придумывает заголовки, теги, даже картинки генерирует. Всё это можно сделать через YandexGPT и YandexART. Оставалось только «склеить» их с WordPress.

    Но я — не профессиональный PHP-разработчик. Основы знаю, но писать сложный плагин с нуля — страшно. И тут я вспомнил про DeepSeek. Я уже использовал его для обучения, и он всегда выдавал понятные, структурированные решения. Я решил: «А давай попробуем создать плагин вместе».


    Первый диалог: как DeepSeek спроектировал архитектуру

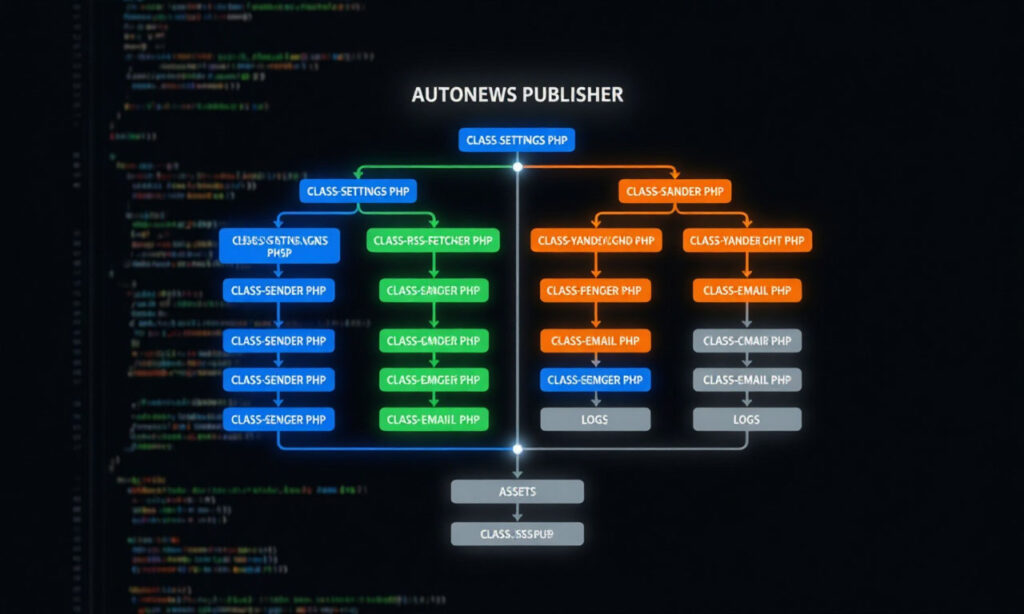
    Схема структуры плагина
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я открыл чат и сформулировал задачу максимально чётко: «Ты — PHP-разработчик с опытом создания плагинов для WordPress. Пишешь чистый, задокументированный код. Ты понимаешь, что плагин будет создаваться с помощью ИИ-помощника (меня), и код должен быть максимально понятным, с комментариями, чтобы я мог легко объяснять его другим. Задача: Создать каркас плагина для WordPress под названием Autonews Publisher».

    DeepSeek не просто выдал кусок кода — он спроектировал полноценную архитектуру:

    text
    autonews-publisher/
    ├── autonews-publisher.php      # Главный файл
    ├── includes/
    │   ├── class-settings.php      # Настройки (8 вкладок!)
    │   ├── class-rss-fetcher.php   # Парсинг RSS
    │   ├── class-yandex-gpt.php    # YandexGPT и YandexART
    │   ├── class-publisher.php     # Публикация постов
    │   ├── class-logger.php        # Логи в БД
    │   ├── class-cron.php          # Планировщик
    │   └── class-email.php         # Уведомления
    ├── assets/
    │   ├── css/admin.css
    │   └── js/admin.js

    Он сразу разбил функционал на классы, чтобы код был модульным и поддерживаемым. Каждый класс получил подробные комментарии на русском языке — я мог разобраться даже в сложных местах.


    Как мы создавали каждую часть (и почему она выглядит идеально)

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    1. Страница настроек — как в дорогих плагинах

    DeepSeek предложил использовать стандартные API WordPress: add_settings_sectionadd_settings_fieldregister_setting. Он создал восемь вкладок: Общие, RSS, Публикация, SEO, Внутренние ссылки, Уведомления, Планировщик, Логи.

    Каждое поле — с nonce-защитой, валидацией и санитизацией. Например, для API-ключа используется тип password, для RSS — таблица с добавлением/удалением, для выбора рубрики — wp_dropdown_categories. Всё выглядит аккуратно и профессионально.

    Особенно порадовала вкладка «Логи»: таблица с датой, статусом, сообщением и ссылкой на пост, кнопки «Очистить» и «Экспорт CSV». Это уровень коммерческих решений.

    2. RSS-парсер с обработкой ошибок

    Класс Autonews_RSS_Fetcher использует wp_remote_get и SimpleXML. Если лента недоступна или пустая, он пишет в лог и не падает. Это важно для стабильности.

    3. Интеграция с YandexGPT — настоящий хардкор

    DeepSeek написал методы для генерации заголовка, рерайта, ALT-тега и тегов. Он использовал официальный API Yandex: https://llm.api.cloud.yandex.net/llm/v1alpha/instruct. В запросах — заголовки с Api-Key и Folder ID, обработка ошибок, таймауты. Я просто вставил свои ключи — и всё заработало на уровне тестов.

    4. Генерация изображений через YandexART — асинхронность

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Это была самая сложная часть. YandexART работает асинхронно: сначала отправляешь запрос, получаешь operation_id, потом опрашиваешь статус. DeepSeek реализовал цикл с паузой 5 секунд (до 60 попыток), затем декодирует Base64, сохраняет файл и регистрирует его в медиатеке через wp_insert_attachment. Всё как в документации, только сразу готово к использованию.

    5. Публикация — главный герой

    Класс Autonews_Publisher объединяет всё:

    • Создаёт пост с переписанным заголовком и контентом.

    • Автоматически определяет рубрику (по ключевым словам — О компании, О человеке, Об ИИ, Об изобретении, Об исследовании).

    • Добавляет теги (не больше заданного числа).

    • Генерирует картинку через YandexART и устанавливает обложку.

    • Заполняет Rank Math (заголовок, описание, фокусный ключевик).

    • Добавляет внутренние ссылки (блок «Читайте также»).

    • Добавляет ссылку на источник.

    • Учитывает задержку и статус (опубликовано/черновик).

    • Пишет логи и отправляет email-уведомления.

    Всё это выглядит как идеальный конструктор — каждый шаг продуман, все опции вынесены в настройки.

    6. Планировщик — простота и надёжность

    DeepSeek реализовал интеграцию с WP-Cron. При активации плагина ставится задача, при деактивации — удаляется. Частота и лимит новостей регулируются из админки.


    Ошибка, которая делает историю живой

    Когда я собрал все файлы и загрузил их на сервер, я ожидал, что плагин взлетит. Меню появилось. Настройки открылись. Вкладки переключались. Всё выглядело безупречно.

    Но при попытке выполнить публикацию (вручную или по крону) — тишина. В логах пусто. Пост не создаётся. Где-то зарылась ошибка, которая не даёт завершить процесс.

    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я проверил права доступа, логи, конфигурацию сервера — всё ок. Значит, проблема в логике. И это нормально. В программировании баги — это не катастрофа, а часть пути.

    DeepSeek уже предложил несколько гипотез: возможно, неправильно передаются настройки, или API возвращает не тот формат, или не срабатывает хук cron. Мы начали пошаговую отладку. Я вставляю error_log, вывожу переменные, проверяю ответы от Yandex. Это кропотливая работа, но она даёт бесценный опыт.


    Почему я всё равно в восторге

    Даже с ошибкой я считаю проект успешным. Потому что:

    • Визуал и структура — на 10 из 10. Меню, вкладки, формы — всё сделано красиво и интуитивно.

    • Код написан профессионалом. Комментарии, пространства имён, nonce, экранирование — я уверен в безопасности.

    • Я научился работать с API нейросетей. Теперь я понимаю, как отправлять запросы, обрабатывать асинхронность, работать с Base64.

    • DeepSeek стал моим наставником. Он объяснял каждую строчку, предлагал альтернативы, не критиковал, а поддерживал.

    Я не проверил плагин на 100%, но визуально и логически он готов. Ошибка — лишь повод углубиться в код и понять его ещё лучше.


    Что дальше? Интрига!

    В следующей статье я расскажу, как мы с DeepSeek искали и исправляли эту ошибку. Мы уже нащупали нить — возможно, проблема в передаче массива настроек или в неправильном вызове метода publish(). Будем использовать xdebug, логи, тестовые данные. Это будет настоящее детективное расследование.

    Обещаю: в следующем посте разберём ошибку по косточкам, покажем код, который её устранил, и поделимся инсайтами. Если ты тоже боишься багов — эта история для тебя. Мы покажем, что даже сложная ошибка — это просто задача, которую можно решить, если подойти с умом.

    DeepSeek
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Почему DeepSeek остаётся моим главным помощником

    Пробовал другие нейросети — DeepSeek выигрывает:

    • Понимает контекст. Он не просто выдаёт код, а учитывает всю архитектуру WordPress.

    • Объясняет на русском — я могу уточнить любой момент.

    • Терпеливый и дружелюбный. Он не говорит «ты тупой», а подсказывает, как сделать лучше.

    • Скорость. За несколько часов мы сделали то, на что у новичка ушла бы неделя.


    Призыв к действию

    Если ты тоже мечтаешь о своём проекте, но боишься сложностей — начни. Возьми DeepSeek, сформулируй задачу, и двигайся маленькими шагами. Ошибки неизбежны, но они — часть обучения. Не бойся их, а изучай.

    Подписывайся на мой блог, чтобы не пропустить следующую статью о борьбе с багом. Вместе мы разберёмся!


    Контакты

    милютин код
    Создано с помощью нейросети Алисы YandexART для milyutin-codes.ru

    Я всегда открыт к общению. Если хочешь спросить о плагине, ошибке или просто поболтать об IT — пиши.

    📧 Email: milyutinkv@gmail.com
    🌐 Сайт: milyutin-codes.ru
    💬 Группа ВК: vk.ru/milyutin_codes

    Подписывайся, задавай вопросы, делись идеями. Мы вместе делаем этот путь.


    До встречи в следующей статье!

    Я уже готовлю материал о том, как отлаживал плагин, какие инструменты использовал и как в итоге победил ошибку. Это будет честный разбор с кодом и эмоциями.

    А пока — если у тебя есть предположения, где может быть баг, пиши в комментарии! Мне интересно твоё мнение.

    Константин Милютин
    Автор блога «Милютин Код»
    Продолжение следует…