Больше месяца я пытался довести до ума PHP-плагин для автопостинга новостей. Исправил 20+ ошибок, научил его работать с YandexGPT, генерировать картинки и заполнять SEO. Но плагин всё равно был капризным — то настройки слетали, то API возвращал 404, то хостинг блокировал соединения.
Я устал. Не физически, а морально. Каждый день я думал: «Ну сколько можно?» И в какой-то момент я понял, что не обязан биться головой об одну и ту же стену. Можно попробовать другой путь.
И я попробовал. Я перешёл на Python.
Сегодня я хочу подвести итог моей работы с DeepSeek за последние недели. Расскажу, что я сделал, с чем столкнулся, какие ошибки уже исправил и какие ещё остались. А главное — поделюсь мыслями о том, что этот проект дал мне как разработчику.
Часть 1. Почему я вообще начал это делать
Изначально я хотел создать систему, которая будет:
-
Парсить RSS-ленты ведущих мировых AI-ресурсов.
-
Переводить новости на русский.
-
Делать рерайт, чтобы они были уникальными.
-
Публиковать на моём сайте milyutin-codes.ru.
-
Всё это без моего участия — просто работает и приносит свежий контент.
Казалось бы, логично — я использую WordPress, значит, и плагин должен быть на PHP. Я написал его, настроил, запустил. И… понеслось.
С чем я столкнулся:
-
Настройки слетали после каждого обновления.
-
YandexGPT возвращал ошибки 404 из-за устаревшего формата запросов.
-
Хостинг блокировал частые запросы к API.
-
Плагин работал внутри WordPress и конфликтовал с другими плагинами.
Я потратил неделю, исправил более 20 ошибок, но плагин всё равно оставался нестабильным. И тогда я понял главное: я не хочу быть «администратором» своего плагина. Я хочу, чтобы он просто работал.
Часть 2. Переход на Python — точка бифуркации
Когда я задал DeepSeek вопрос: «Может, реализовать автопостинг на Python, если это проще?» — он ответил: «Да, на Python будет проще». И оказался прав.
Python — это язык для автоматизации. Он не привязан к WordPress, не зависит от версий PHP и не конфликтует с плагинами. Он просто делает свою работу и завершается.
Что изменилось после перехода:
-
Скрипт работает независимо от сайта.
-
Ошибки не валят WordPress.
-
Я могу запускать его по расписанию через cron.
-
Код стал проще и понятнее.
Вывод: иногда правильное решение — не «починить» текущую систему, а «пересесть» на другую.
Часть 3. Эволюция плагина: хронология ключевых изменений
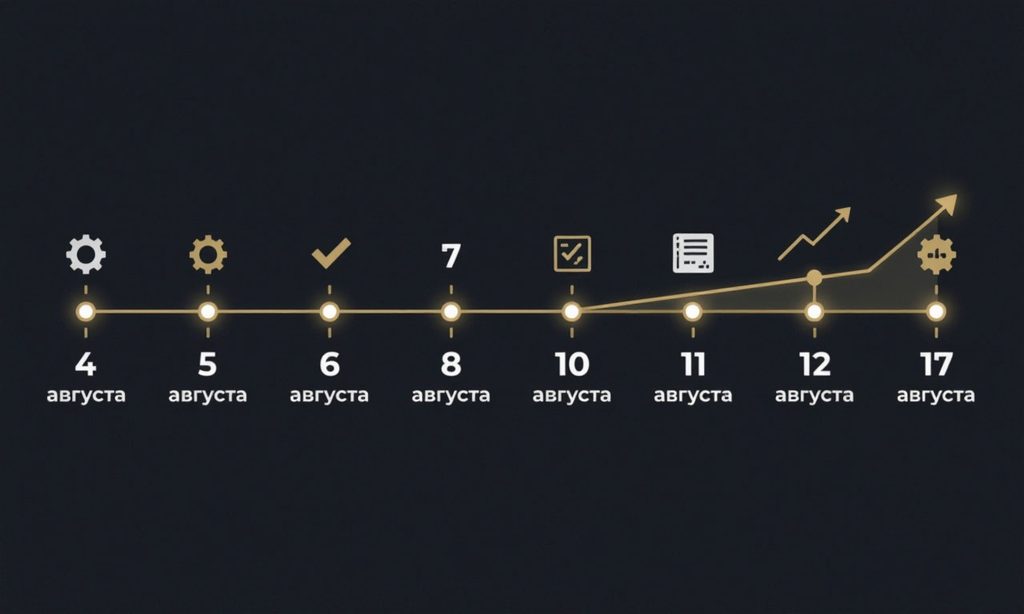
За время работы я внёс множество доработок. Вот основные этапы:
4 августа 2026 — Публикация дубликатов из-за неверной проверки
Проблема: Скрипт проверял дубликаты по переведённому заголовку, который при каждом новом запуске отличался из-за вариативности перевода. Это приводило к многократной публикации одной и той же новости.
Решение: Переработана логика проверки дубликатов. Теперь скрипт использует оригинальный заголовок из RSS и сохраняет RSS GUID в мета-поля поста. При повторной проверке сначала идёт поиск по GUID, затем по нормализованному заголовку (очищенному от кавычек и знаков препинания).
5 августа 2026 — Ошибка 401 при создании тегов и публикации
Проблема: WordPress REST API не принимал обычный пароль пользователя, возвращая 401 – rest_cannot_create.
Решение: В инструкцию добавлено требование использовать пароль приложения (Application Password), создаваемый в профиле пользователя. В коде исправлена авторизация через базовую аутентификацию.
6 августа 2026 — Парсинг дат работал нестабильно
Проблема: Скрипт не мог корректно распарсить даты в формате RFC 2822, из-за чего подставлял текущее время, и старые статьи публиковались повторно.
Решение: Внедрена функция normalize_date(), использующая встроенный парсер feedparser и email.utils. Добавлено извлечение даты из HTML-мета-тегов (article:published_time).
7 августа 2026 — Логика очереди публикаций
Проблема: При ручном запуске или по расписанию публиковалась только самая свежая новость, а все остальные терялись.
Решение: Внедрена система очереди. Новые записи добавляются в список pending_entries в config.json, а затем публикуются по одной при каждом запуске.
8 августа 2026 — Дублирование при первом запуске
Проблема: При первом запуске скрипт добавлял в очередь все записи из RSS, включая старые, и начинал их публиковать.
Решение: Добавлена логика «первого запуска»: если last_published_date отсутствует, публикуется только самая свежая запись, а остальные игнорируются.
10 августа 2026 — Ошибка 403 от Wordfence при обновлении Rank Math
Проблема: Плагин безопасности Wordfence блокировал запросы к эндпоинту /rankmath/v1/updateMeta, возвращая 403 Forbidden.
Решение: Обновление SEO-мета-полей перенесено на стандартный REST API WordPress (/wp/v2/posts/{id}) с передачей данных в поле meta. Добавлен корректный User-Agent.
11 августа 2026 — Иерархические категории
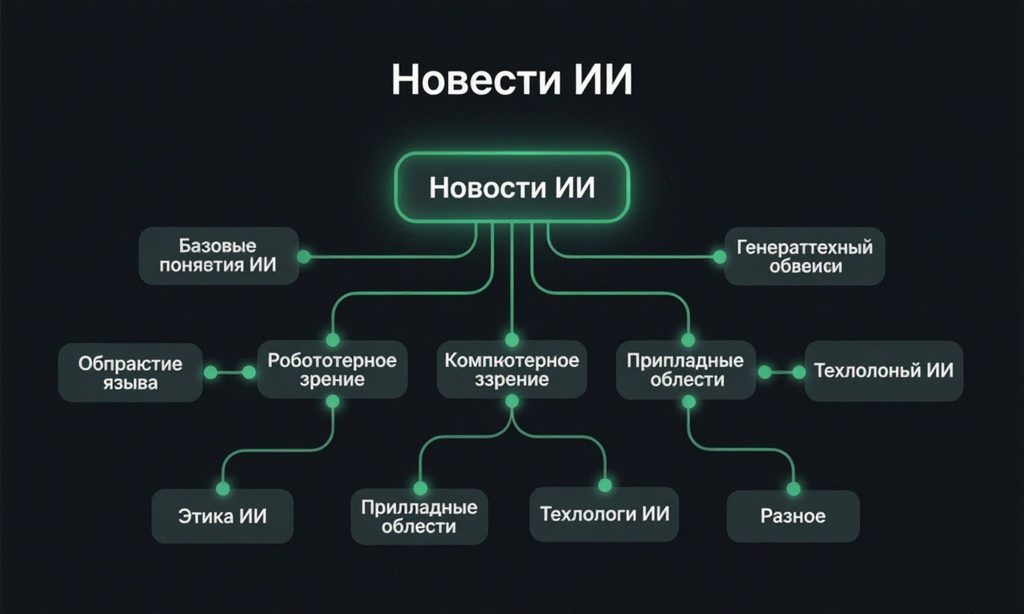
Проблема: Все новости публиковались в одну категорию, без структурирования по темам.
Решение: Реализована иерархическая система категорий:
-
Родительская категория: «Новости ИИ» (slug:
novosti-ii). -
Дочерние подрубрики: 9 штук + «Разное» для нераспознанных новостей.
-
Автоматическое создание недостающих категорий при первом запуске.
12 августа 2026 — Определение компании и перевод длинных статей
Проблема:
-
Названия компаний переводились на русский, терялась идентичность.
-
Статьи длиннее 2500 символов обрезались или переводились с ошибками.
Решение:
-
Добавлена функция
extract_company_name(), которая отдельным запросом к YandexGPT определяет главную компанию (на английском) и использует её в SEO-полях и alt-текстах. -
Реализована разбивка длинных текстов на части (
split_text_into_chunks()), каждая часть переводится отдельно, затем результаты склеиваются.
17 августа 2026 — Очистка ответов YandexGPT
Проблема: В названиях компаний появлялись лишние слова («Amazon Вопрос», «Meta Вопрос»), а иногда скрипт не мог распарсить ответ.
Решение: Ужесточены промпты для YandexGPT, добавлена очистка ответов от стоп-слов и переносов строк. Введена повторная попытка генерации заголовка и тегов с альтернативным форматом.
Часть 4. Что я получил в итоге

После всех доработок плагин:
-
Публикует новости строго по очереди, без дубликатов.
-
Корректно определяет компании и использует их в SEO.
-
Автоматически создаёт иерархию категорий.
-
Переводит статьи любого объёма (разбивка на части).
-
Обновляет SEO-поля Rank Math через стандартный REST API.
-
Работает 24/7 на сервере как systemd-служба.
-
Извлекает изображения из оригинальных статей и вставляет их в пост.
-
Очищает текст от рекламы и мусора.
-
Добавляет ссылку на источник в виде аккуратного домена.
Часть 5. Что ещё осталось исправить
Плагин работает, но всё ещё есть мелкие ошибки, которые я исправляю в данный момент:
-
Иногда YandexGPT возвращает 400 — если промпт слишком длинный или формат нарушен. Добавил обрезку текста до 3000 символов и логирование ответа, но иногда ошибка всё равно возникает.
-
Изображения не всегда загружаются — если URL картинки битый или сайт блокирует запросы. Пока просто пропускаю, но планирую добавить повторные попытки.
-
SEO-поля Rank Math обновляются не всегда — иногда API возвращает 404, если пост только что создан. Добавил задержку перед обновлением мета-полей.
-
На тестовом домене иногда слетают настройки — потому что я часто перезапускаю скрипт и меняю конфиг. Это не критично, но нужно будет исправить.
-
Некоторые RSS-ленты не парсятся — если сайт использует нестандартный формат или требует авторизации.
Но я не отчаиваюсь. Каждая ошибка — это урок. И я исправляю их одну за другой.
Часть 6. Мои главные выводы
1. Не бойтесь менять инструменты.
Если PHP-плагин не работает — напишите на Python. Это быстрее, чем пытаться «починить» то, что сломано по своей сути.
2. Качество контента — это не только текст.
Картинки, структура, категории — всё это влияет на восприятие. ИИ может помочь с текстом, но структуру и логику контента должен продумывать человек.
3. Автоматизация не заменяет человека.
Я автоматизировал сбор, перевод и публикацию новостей. Но я всё равно проверяю их, редактирую, если нужно, и думаю о том, как улучшить систему.
4. ИИ — это инструмент, а не волшебная таблетка.
YandexGPT помогает мне писать тексты, но я отвечаю за то, как они звучат. Python помогает мне автоматизировать рутину, но я отвечаю за то, как система работает.
5. DeepSeek — идеальный напарник.
Он объясняет, подсказывает, исправляет ошибки и не даёт опустить руки. Без него я бы не справился.
Часть 7. Что дальше?
Как только я исправлю все оставшиеся мелкие ошибки, я выложу код плагина в свободный доступ на своём сайте. Чтобы любой желающий мог скачать его, настроить под себя и использовать для своего WordPress-сайта.
В ближайших планах:
-
Добавить поддержку нескольких RSS-источников одновременно.
-
Реализовать более умное распознавание ключевых сущностей.
-
Внедрить логирование в базу данных для статистики.
-
Добавить пагинацию на страницах «Блог» и «Новости ИИ».
-
Настроить RSS-ленту для новостей.
Призыв к действию
Если ты тоже разработчик-самоучка и иногда чувствуешь, что застрял — вспомни мою историю. Иногда правильнее не биться головой о стену, а найти обходной путь. Взять паузу. Сделать шаг назад, чтобы потом прыгнуть дальше.
Подписывайся на мой блог, чтобы не пропустить новость о выходе готового плагина в открытый доступ.
Контакты
📧 Email: milyutinkv@gmail.com
🌐 Сайт: milyutin-codes.ru
💬 Группа ВК: vk.ru/milyutin_codes
Задавай вопросы, делись идеями, пиши свои истории. Мы вместе.
Продолжение следует. Скоро — открытый код.
Константин Милютин
Автор блога «Милютин Код»